一、了解自然语言处理
学习目标
完成本单元后,你将能够:
- 描述自然语言处理(NLP)
- 讨论 NLP 的日常用途
- 解释它自 1950 年代以来的演变
- 区分自然语言处理、自然语言理解、自然语言生成
什么是自然语言处理?(上)
自然语言处理(NLP)是人工智能(AI)的一个领域,结合计算机科学和语言学,让应用和 AI 助手能够以对人类有意义、有用的方式理解、解释和生成人类语言。NLP 帮助应用、AI 助手和自主代理执行任务,如理解句子含义、识别文本中的重要细节、翻译语言、回答问题、摘要文本,以及生成类人的回复。
NLP 已经普遍到我们日常通常都不会察觉它在为我们做事。例如:很多人用 ChatGPT 生成或摘要文本或回答问题;邮件或文档应用自动建议下一个词或短语;你可能会让 Siri 等虚拟助手提醒你周二给植物浇水;或者用自主代理预订假期(包括交通和目的地旅游)。
什么是自然语言处理?(下)
你联系公司客服时互动的代理使用 NLP;你在国外点餐用的翻译应用也使用 NLP。垃圾邮件检测、你的在线新闻偏好等等,都依赖 NLP。
NLP 简史(上)
值得一提的是,NLP 并不新。事实上,它的根源可追溯到 1950 年代,当时研究者开始用计算机理解和生成人类语言。NLP 最早的重要贡献之一是图灵测试(Turing Test)——由 Alan Turing 开发,衡量机器回答问题的方式是否与人类无异。
之后不久,第一批机器翻译系统被开发出来——这些基于句子和短语的语言翻译实验进展不大,因为它们依赖非常特定的语言模式(如预定义的短语或句子)。到了 1960 年代,研究者开始试验基于规则的系统,让用户要求计算机完成任务或进行对话。
NLP 简史(下)
1970-80 年代出现了更复杂的基于知识的方法,使用语言规则、基于规则的推理和领域知识来执行命令、诊断疾病等任务。
1990 年代到 2000 年代初,统计方法(即从数据中学习)在 NLP 中流行,推动了语音识别、机器翻译和机器学习算法的进步。这一时期,1993 年万维网的引入为 NLP 研究提供了海量的文本数据。
大约从 2009 年起,神经网络和深度学习主导了 NLP 的研究与开发。翻译和自然语言生成(包括 ChatGPT)领域大幅改进并持续快速演进。
人类语言是"自然"语言
到底什么是自然语言?自然语言指人类用词语和句子相互交流的方式——我们对话、阅读、书写、倾听时使用的语言。自然语言是我们传达信息、表达想法、提问、讲故事、在社交媒体上互动的方式。但 AI 如何解释自然语言?要回答这个问题,我们需要看看信息和数据是如何结构化的。
注意:虽然 NLP 模型已为许多不同人类语言开发,本模块专注于英语的 NLP。
结构化与非结构化数据(上)
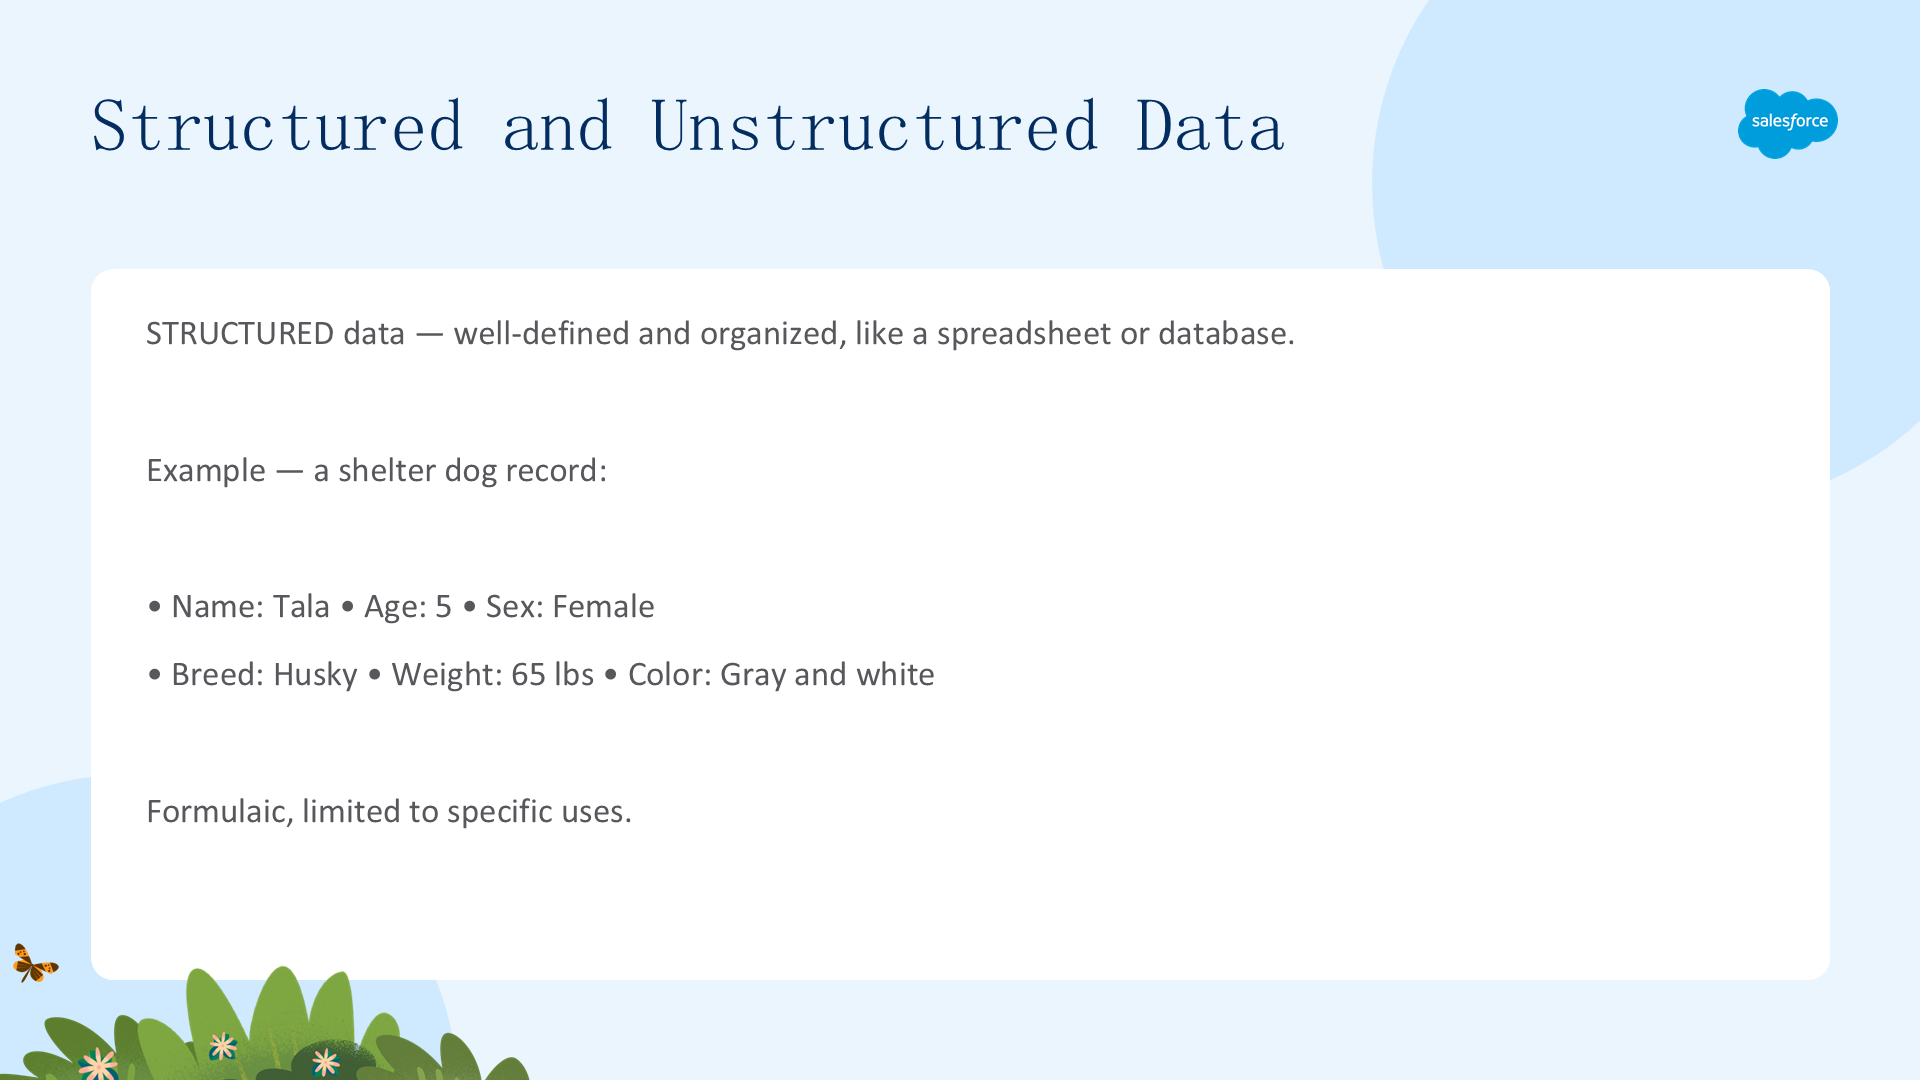
过去,计算机要理解我们的意思,信息需要良好定义和组织,类似电子表格或数据库中的内容——这被称为结构化数据。结构化数据中的信息及其格式最终由终端应用使用的算法决定,通常需要额外的数据录入或解析。
以收容所里一只待领养狗的数据为例,作为结构化数据(帮助匹配宠物与潜在领养人):姓名 Tala、年龄 5、已绝育、雌性、哈士奇、体重 65 磅、灰白色、蓝眼睛、对儿童友好、对猫友好、喜欢公园/徒步/梳毛、位于 Troutdale。这类数据的输出(如特定宠物类型的搜索结果或网站描述)会是公式化的、局限于特定用途。
结构化与非结构化数据(下)
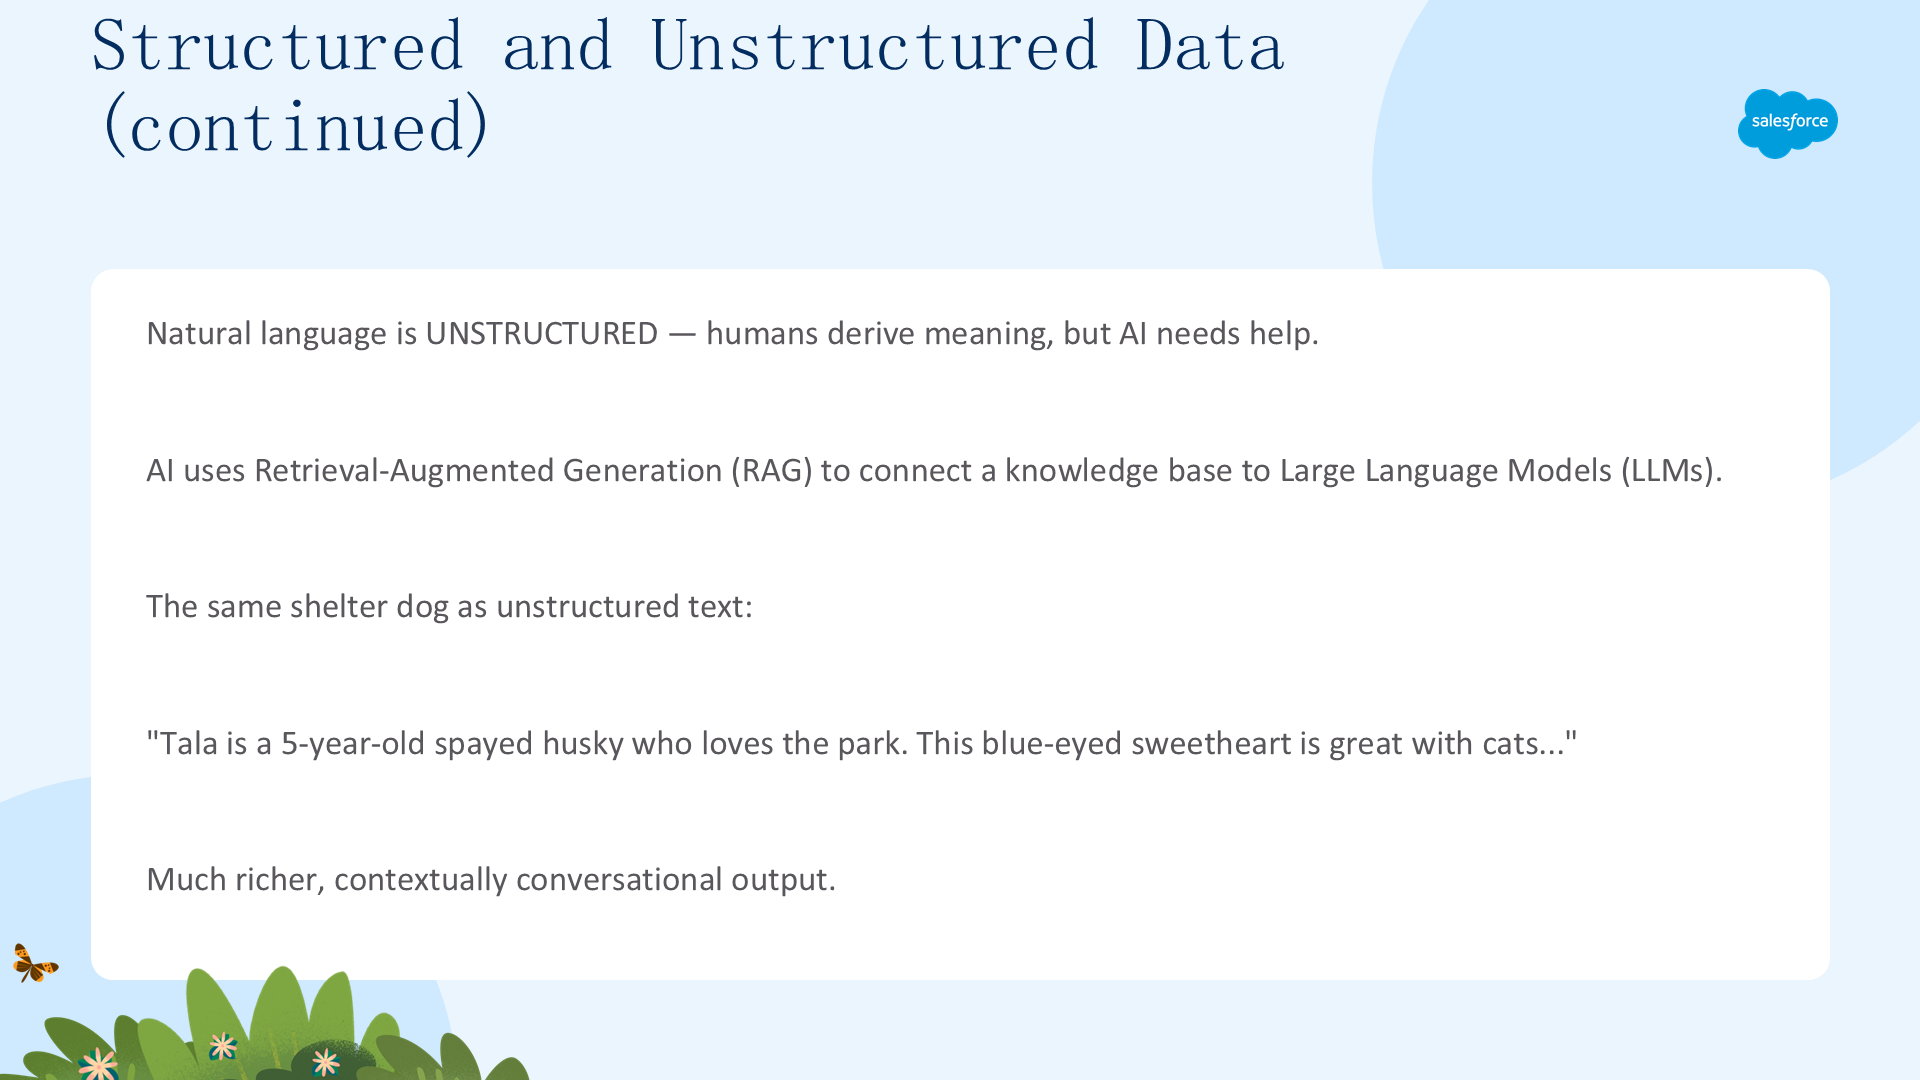
然而,自然语言——我们实际的说话方式——是非结构化的。虽然人类通常能从中理解含义,但 AI 需要像 检索增强生成(RAG)这样的工具,把企业的数据或知识库连接到大语言模型(LLM),才能理解并增强文本、语音和生成结果的上下文和准确性。
以下段落展示了同一只收容所狗的信息作为非结构化数据呈现,AI 如何在多种用例中提供更丰富、更有语境的输出:"Tala 是一只 5 岁、已绝育、体重 65 磅的雌性哈士奇,喜欢在公园玩耍和长途徒步。她对幼儿非常温和,与猫相处融洽。这个蓝眼睛的小甜心有长长的灰白色毛发,需要定期梳理。你可以致电 Troutdale 收容所预约见面。"
自然语言理解与生成(上)
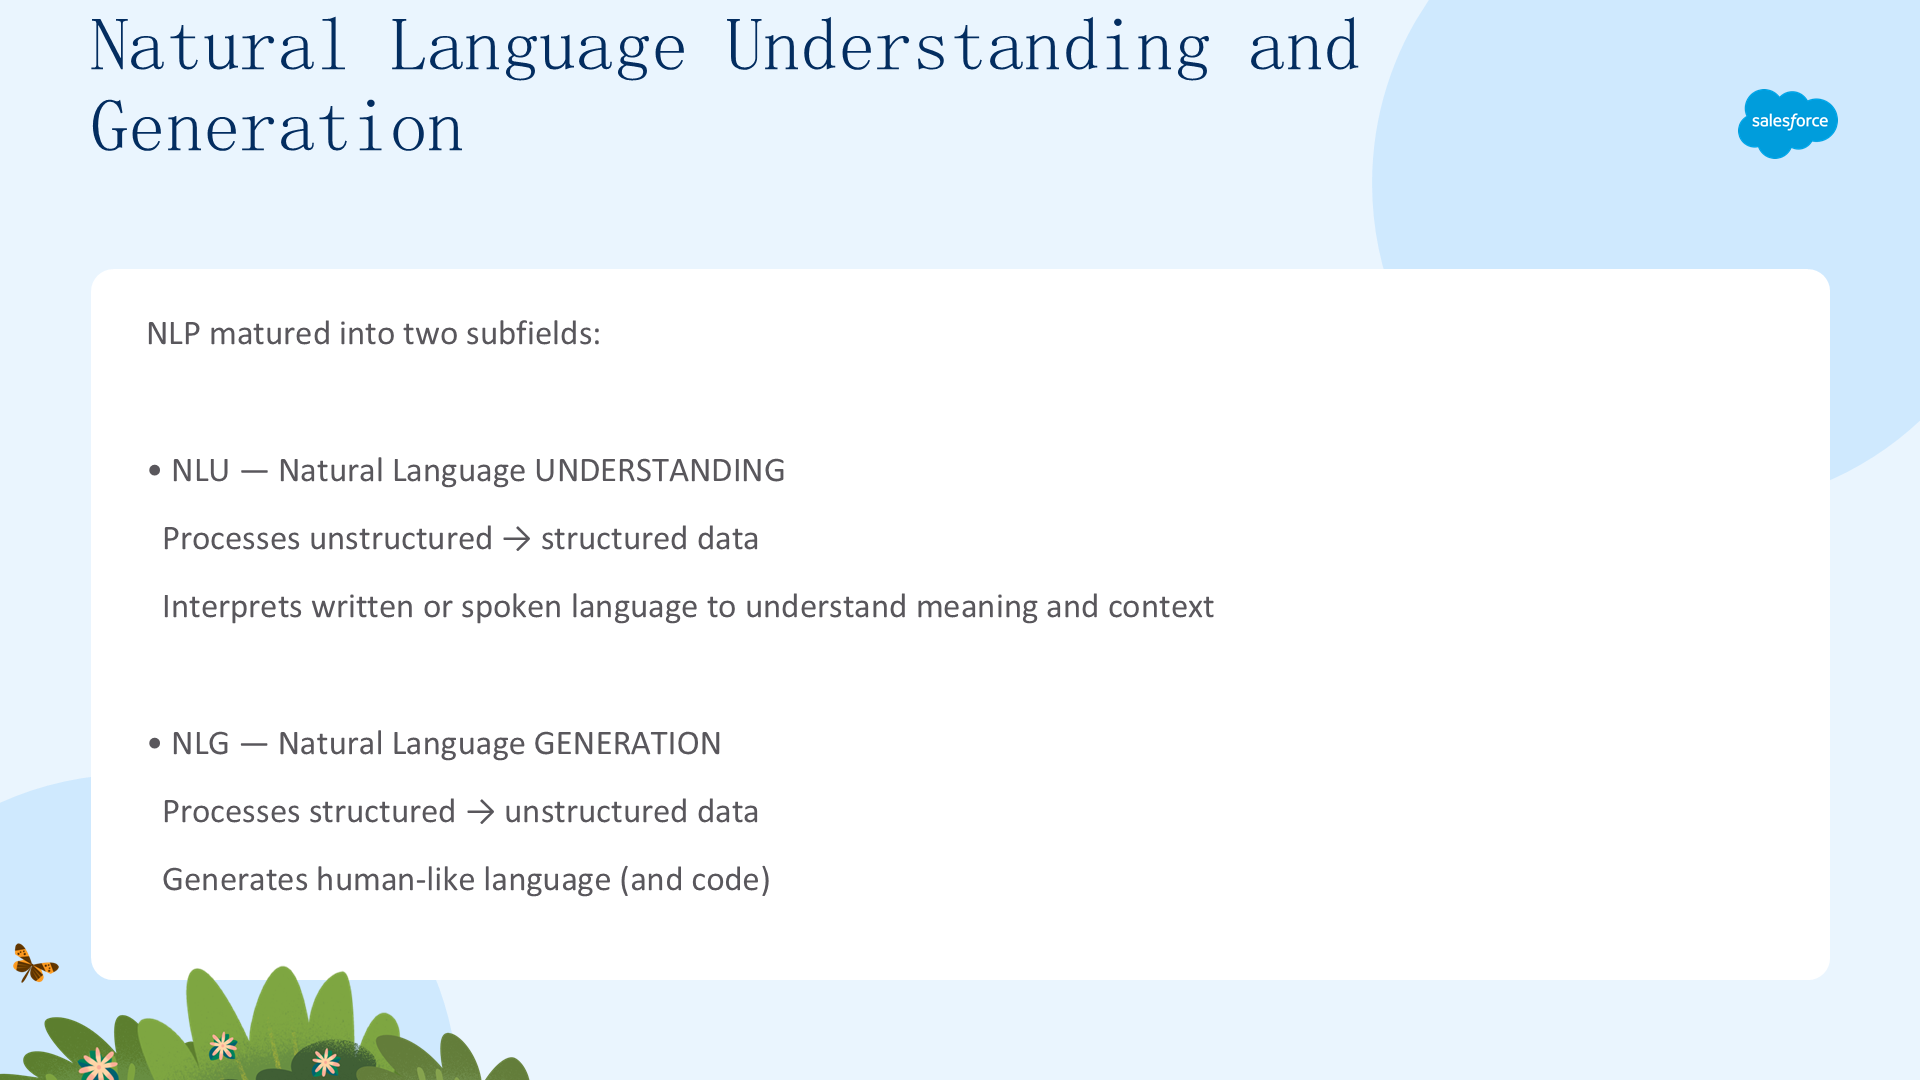
今天的 NLP 成熟为两个子领域:自然语言理解(NLU)和自然语言生成(NLG)。
数据从非结构化处理到结构化,称为自然语言理解(NLU)。NLU 使用多种技术解读书面或口头语言,理解其背后的含义和上下文。
数据按相反方向处理——从结构化到非结构化——称为自然语言生成(NLG)。NLG 让 AI 助手能够生成类人语言。NLG 涉及开发把结构化数据或信息转化为有意义、上下文恰当、类人文本或语音的算法和模型,也包括生成编程语言代码(如生成排序字符串的 Python 函数)。
自然语言理解与生成(下)
过去,NLU 和 NLG 任务使用显式的语言结构表示,如解析树(parse trees)。虽然 NLU 和 NLG 今天仍对 NLP 至关重要,但我们互动的大多数应用、工具和虚拟助手已演进为使用深度学习或神经网络端到端地执行任务。
例如,神经机器翻译系统可以把一句话(比如中文)直接翻译成英语,而无需显式创建任何中间结构。神经网络识别模式、词和短语,让语言处理成倍加快、上下文更准确。
二、了解自然语言解析
学习目标
完成本单元后,你将能够:
- 讨论自然语言的基本要素
- 描述解析自然语言时使用的几种重要技术
- 解释情感、意图和语境分析如何贡献 NLP
自然语言的基本要素(上)
理解和处理自然语言是技术的基本挑战——因为它不仅涉及识别单词,还涉及理解它们的关系、语境和含义。
我们的自然语言(文本和语音)具有无穷的复杂性、细微差别、歧义和错误。日常交流中,我们会遇到多种含义的词、发音相同但拼写和含义不同的词、错位的修饰语、拼写错误、发音错误,还有说话快、含糊或啰嗦的人,以及使用不同口音或方言的人。
以这个句子为例:"We saw six bison on vacation in Yellowstone National Park."(我们在黄石国家公园度假时看到了六头野牛。)你可能会想象六头戴着帽子和太阳镜的野牛在老忠实泉前自拍的搞笑画面,但更可能你理解的是实际发生的事——一个在黄石度假的人看到了六头野牛。
自然语言的基本要素(下)
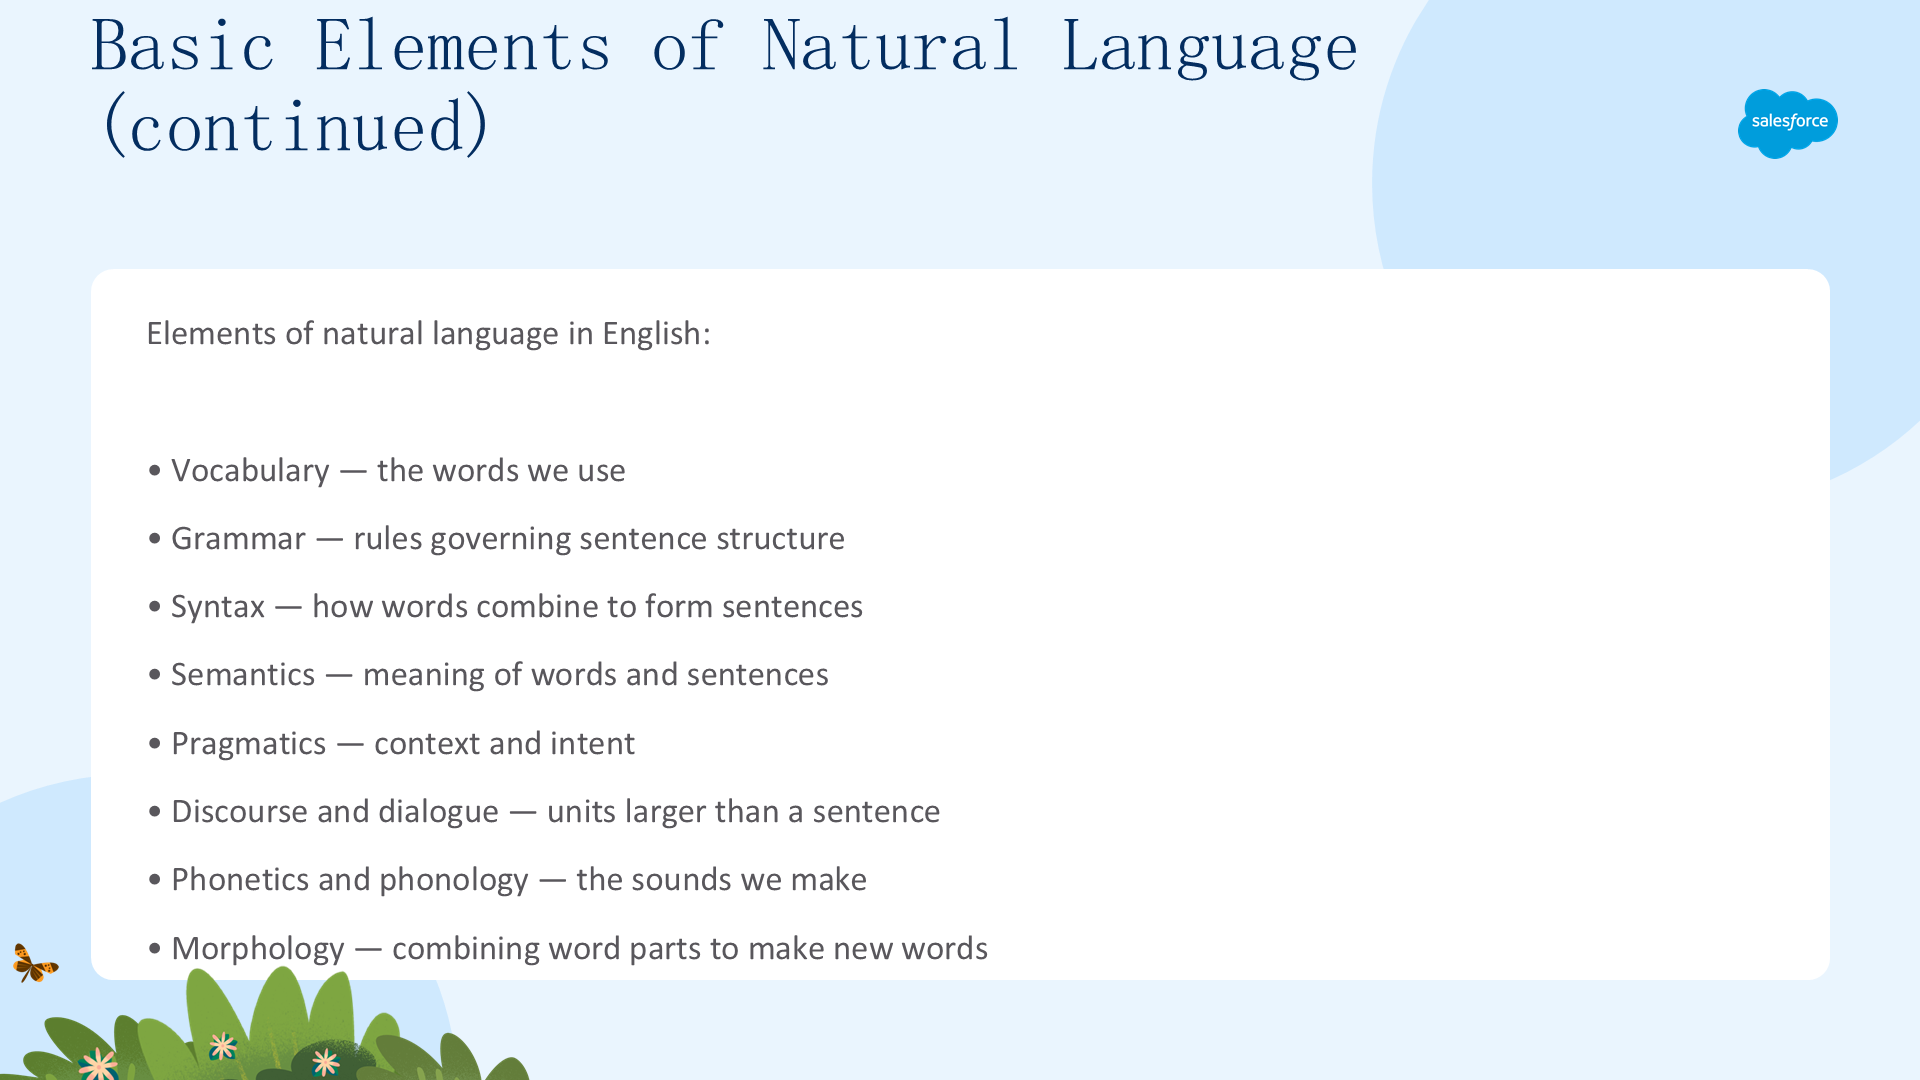
英语自然语言的要素包括:
- 词汇(Vocabulary):我们使用的词语
- 语法(Grammar):管理句子结构的规则
- 句法(Syntax):词语如何按语法组合成句子
- 语义(Semantics):词、短语和句子的含义
- 语用学(Pragmatics):文化或地理语言使用背后的语境和意图
- 话语与对话(Discourse and dialogue):大于单个短语或句子的单元,包括文档和对话
- 语音学与音系学(Phonetics and phonology):我们交流时发出的声音
- 形态学(Morphology):词的部分如何组合或拆分以构成新词
解析自然语言
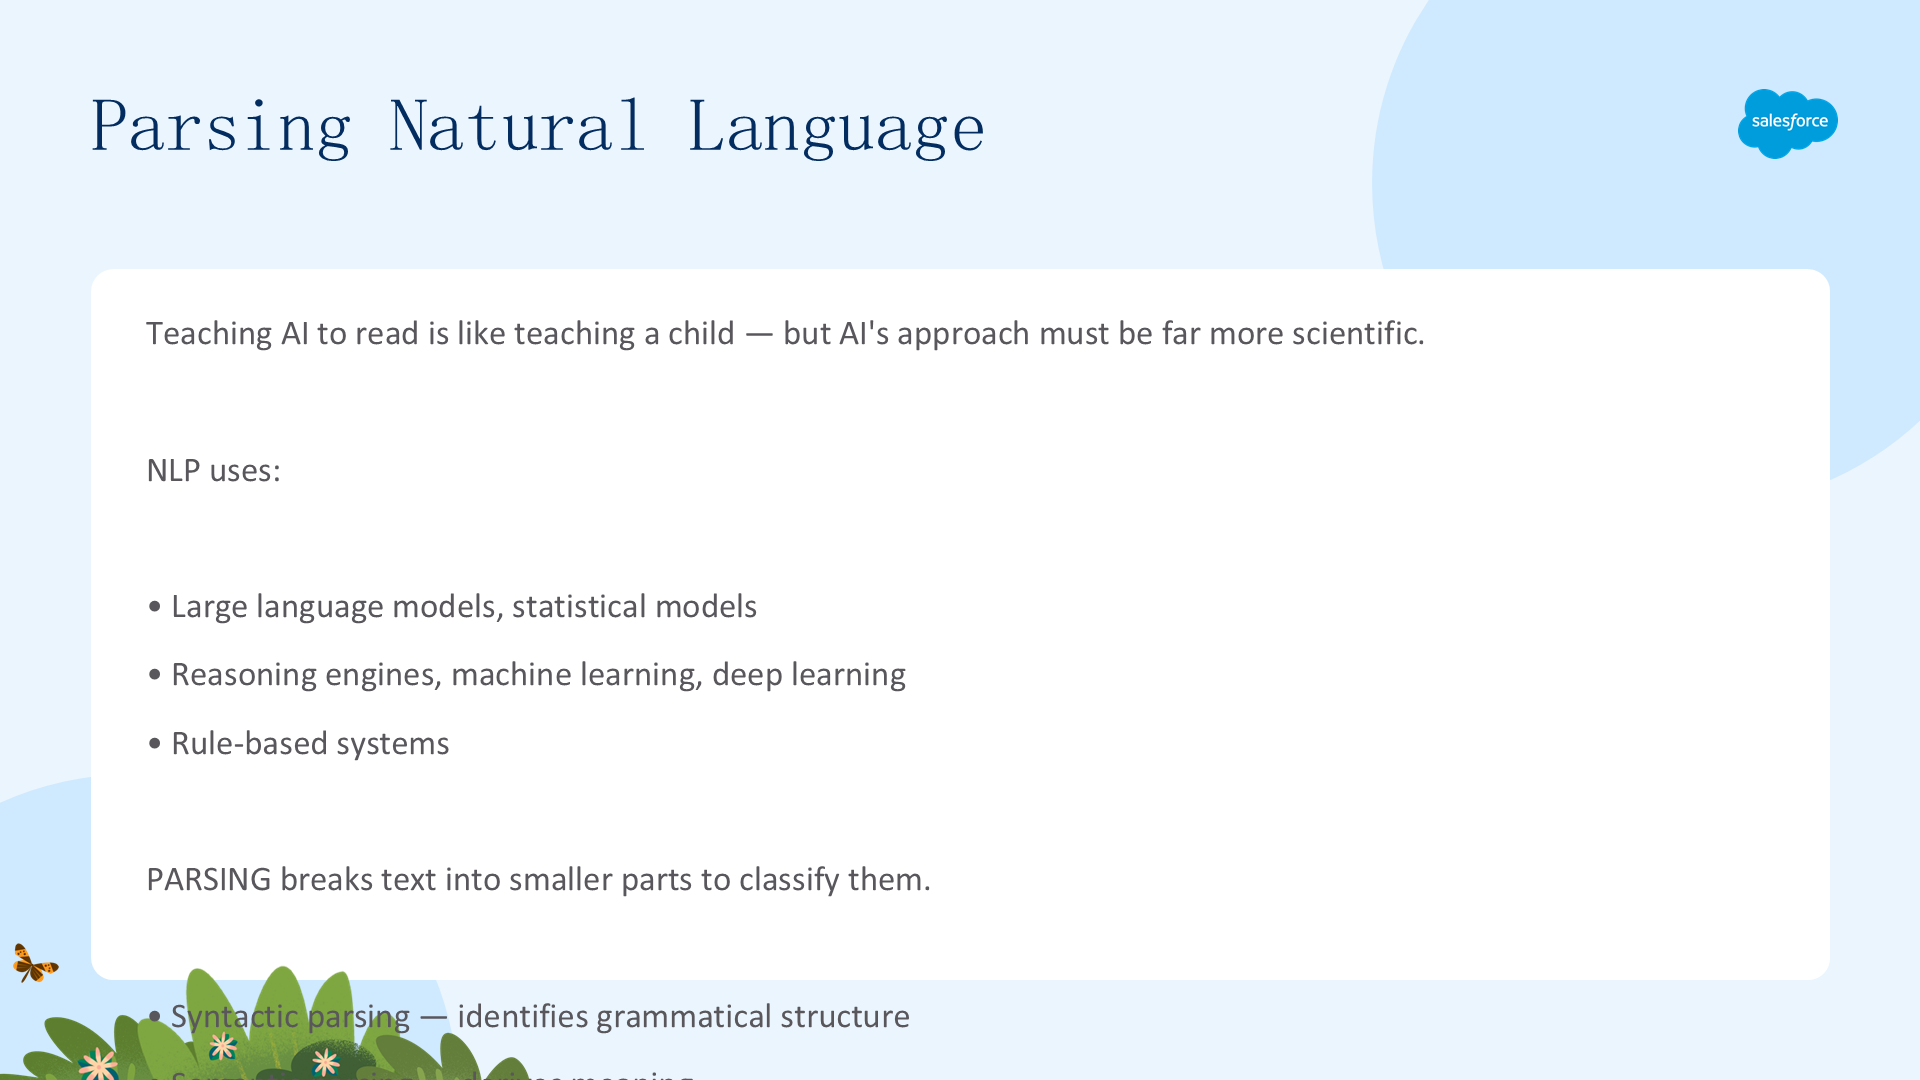
教 AI 助手或代理从词语中读取并推导含义,有点像教孩子阅读——两者都学习识别词、发音、含义和发音方式。但计算机是另一种"聪明",所以虽然它需要理解上述自然语言要素,方法却要科学得多。
NLP 使用 大语言模型(LLM)、统计模型、推理引擎、机器学习、深度学习和基于规则的系统等算法和方法来处理和分析文本。这些技术统称为解析(parsing)——把文本或语音拆成更小的部分加以分类。解析包括句法解析(syntactic parsing)(分析自然语言要素以识别底层语法结构)和语义解析(semantic parsing)(推导含义)。
自然语言会根据预期结果以不同方式解析——翻译应用用的算法/模型,与代理或 Alexa 等虚拟助手用的不同。
句法解析
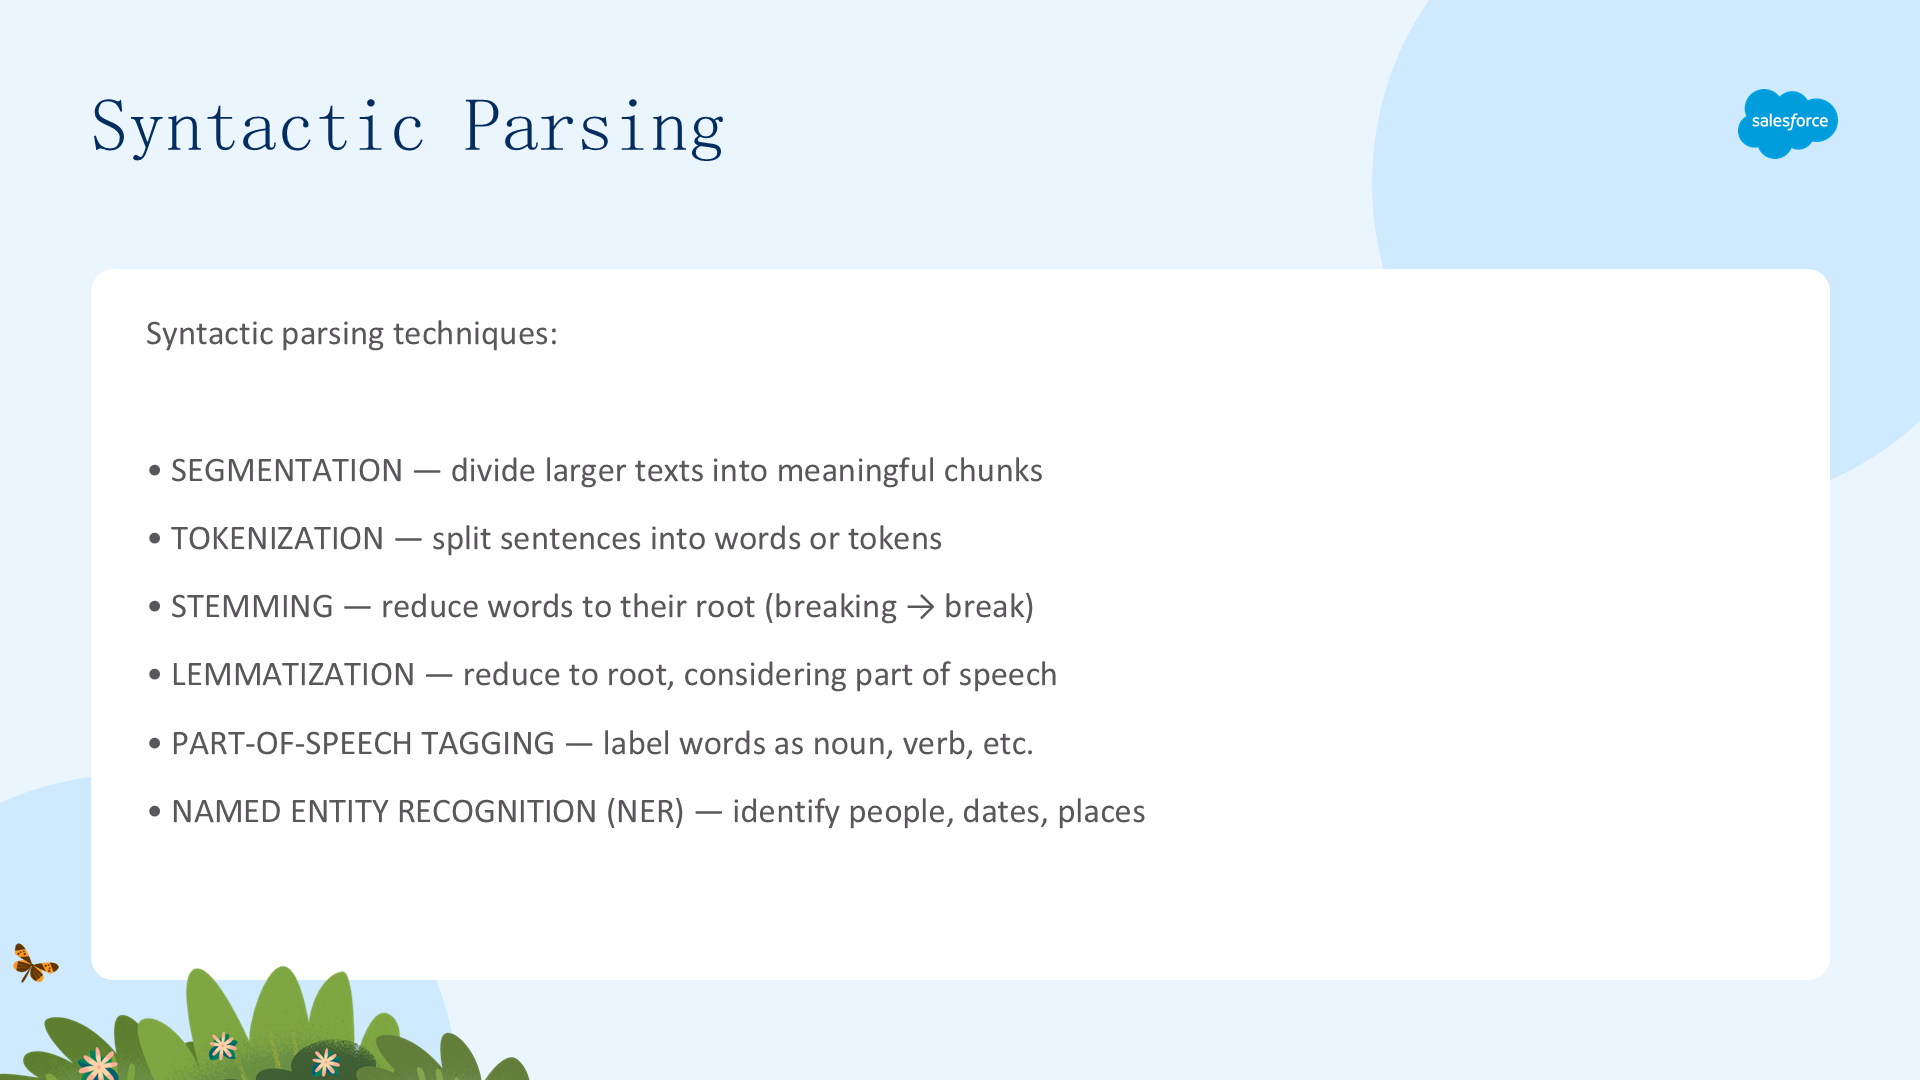
句法解析可能包括:
- 分割(Segmentation):把较大文本分成更小、有意义的块,通常在句子末尾的标点处分割。
- 词元化(Tokenization):把句子拆成单词、词的一部分甚至单个字符(称为 token)。英语中词元化较直接(词常被空格分隔),但泰语、中文、德语等语言则复杂得多,依赖词汇和形态学的理解。
- 词干提取(Stemming):把词归约到根形式(stem),如 breaking、breaks、unbreakable 都归约到 break。
- 词形还原(Lemmatization):类似词干提取,但考虑词性以得到更有效的词根(lemma)。
- 词性标注(Part of speech tagging):给每个词标注语法标签(名词、形容词、动词等),帮助计算机理解句法。
- 命名实体识别(NER,Named Entity Recognition):识别并分类文本中的人名、日期、地点、组织等命名实体。
句法解析:词干提取 vs 词形还原
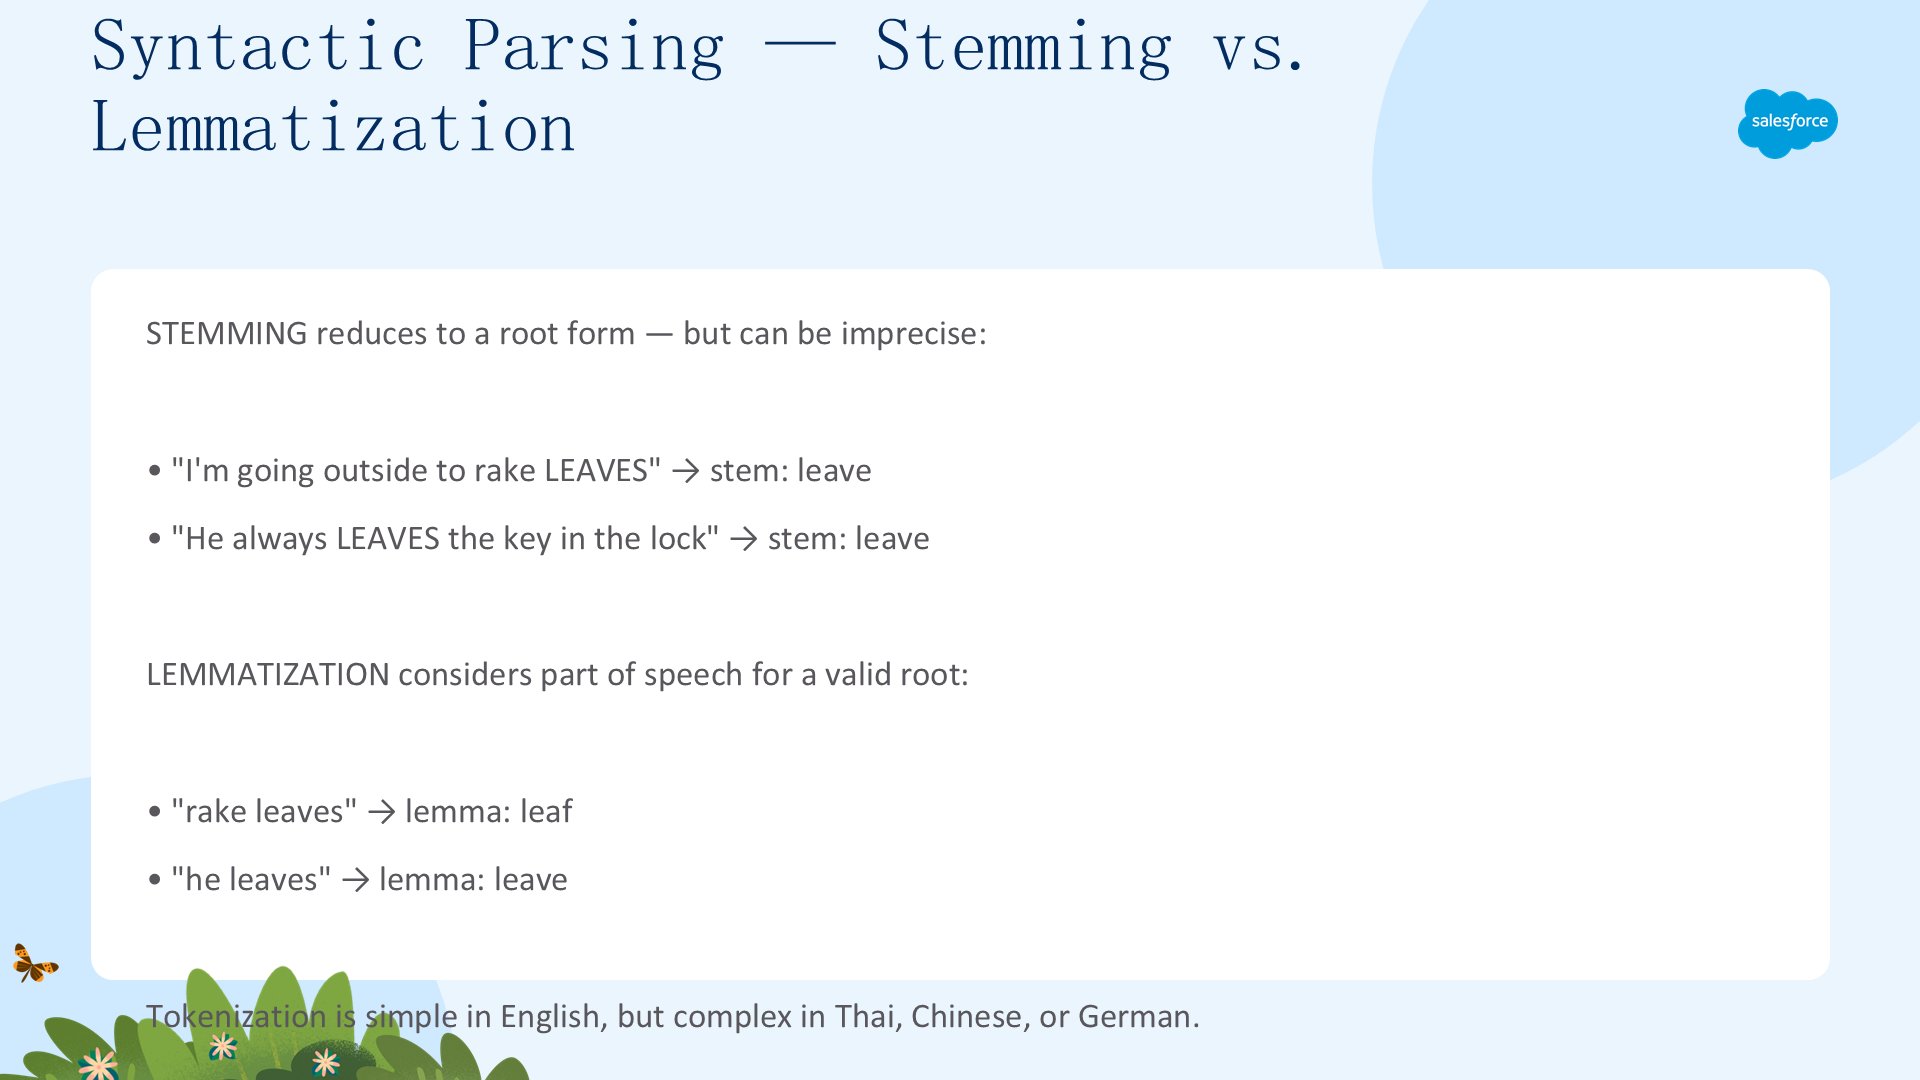
词干提取把词归约到词根,但根据上下文可能得不到最准确的词干。看这两个使用词干提取的例子:
- Stem = leave → "I'm going outside to rake leaves."(我要出去耙树叶)
- Stem = leave → "He always leaves the key in the lock."(他总把钥匙留在锁里)
词形还原考虑词性,得到更有效的词根(lemma):
- Lemma = leaf → "I'm going outside to rake leaves."(叶子)
- Lemma = leave → "He always leaves the key in the lock."(留下)
语义分析
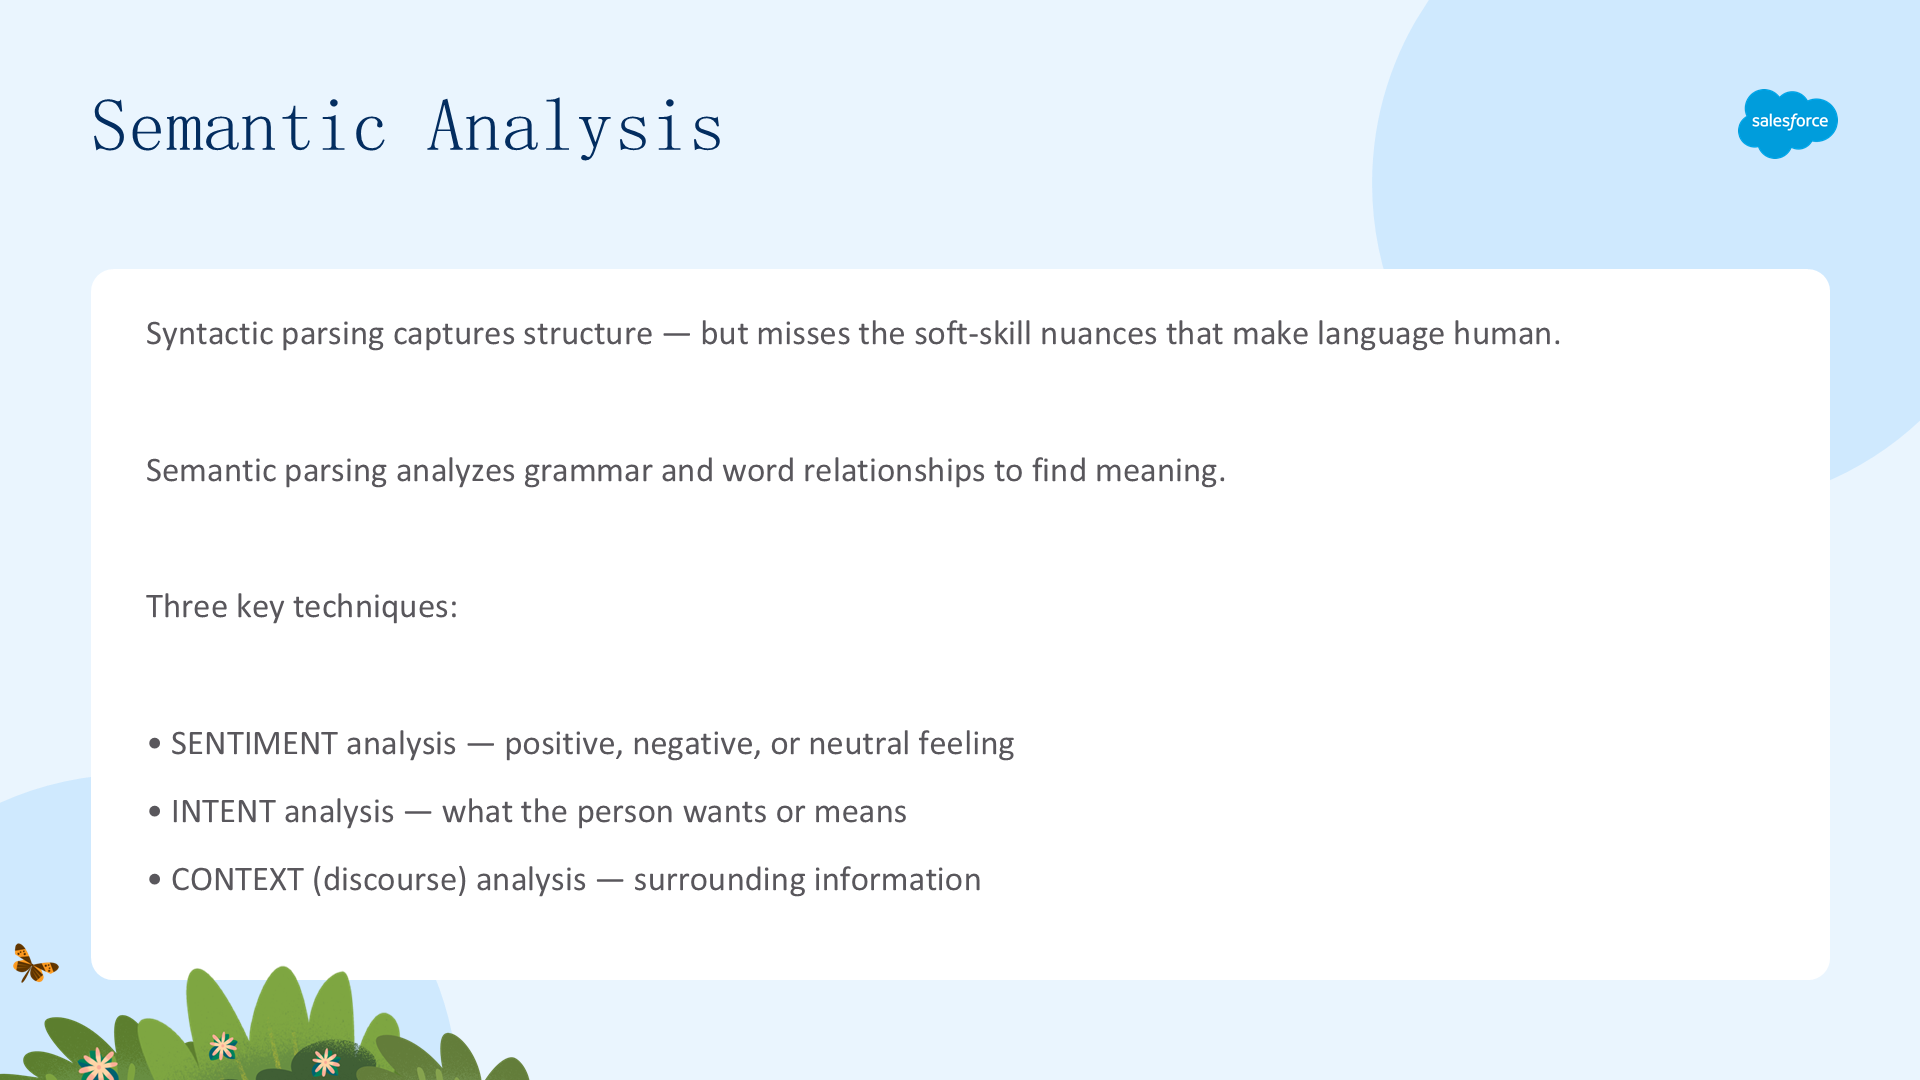
用上述句法步骤解析自然语言能很好地捕捉文本或语音的结构,但缺乏让人类语言"像人"的软技能细微差别。语义解析涉及分析句子的语法格式以及词和短语之间的关系,以找到含义表示。提取人们的感觉、互动的原因以及互动环境的细节,对准确解读文本或语音并形成恰当回复至关重要。
以下是 NLP 中常用的几种分析技术,每种技术可由不同算法驱动,以达到根据具体任务和分析复杂度所需的理级。
语义分析实战
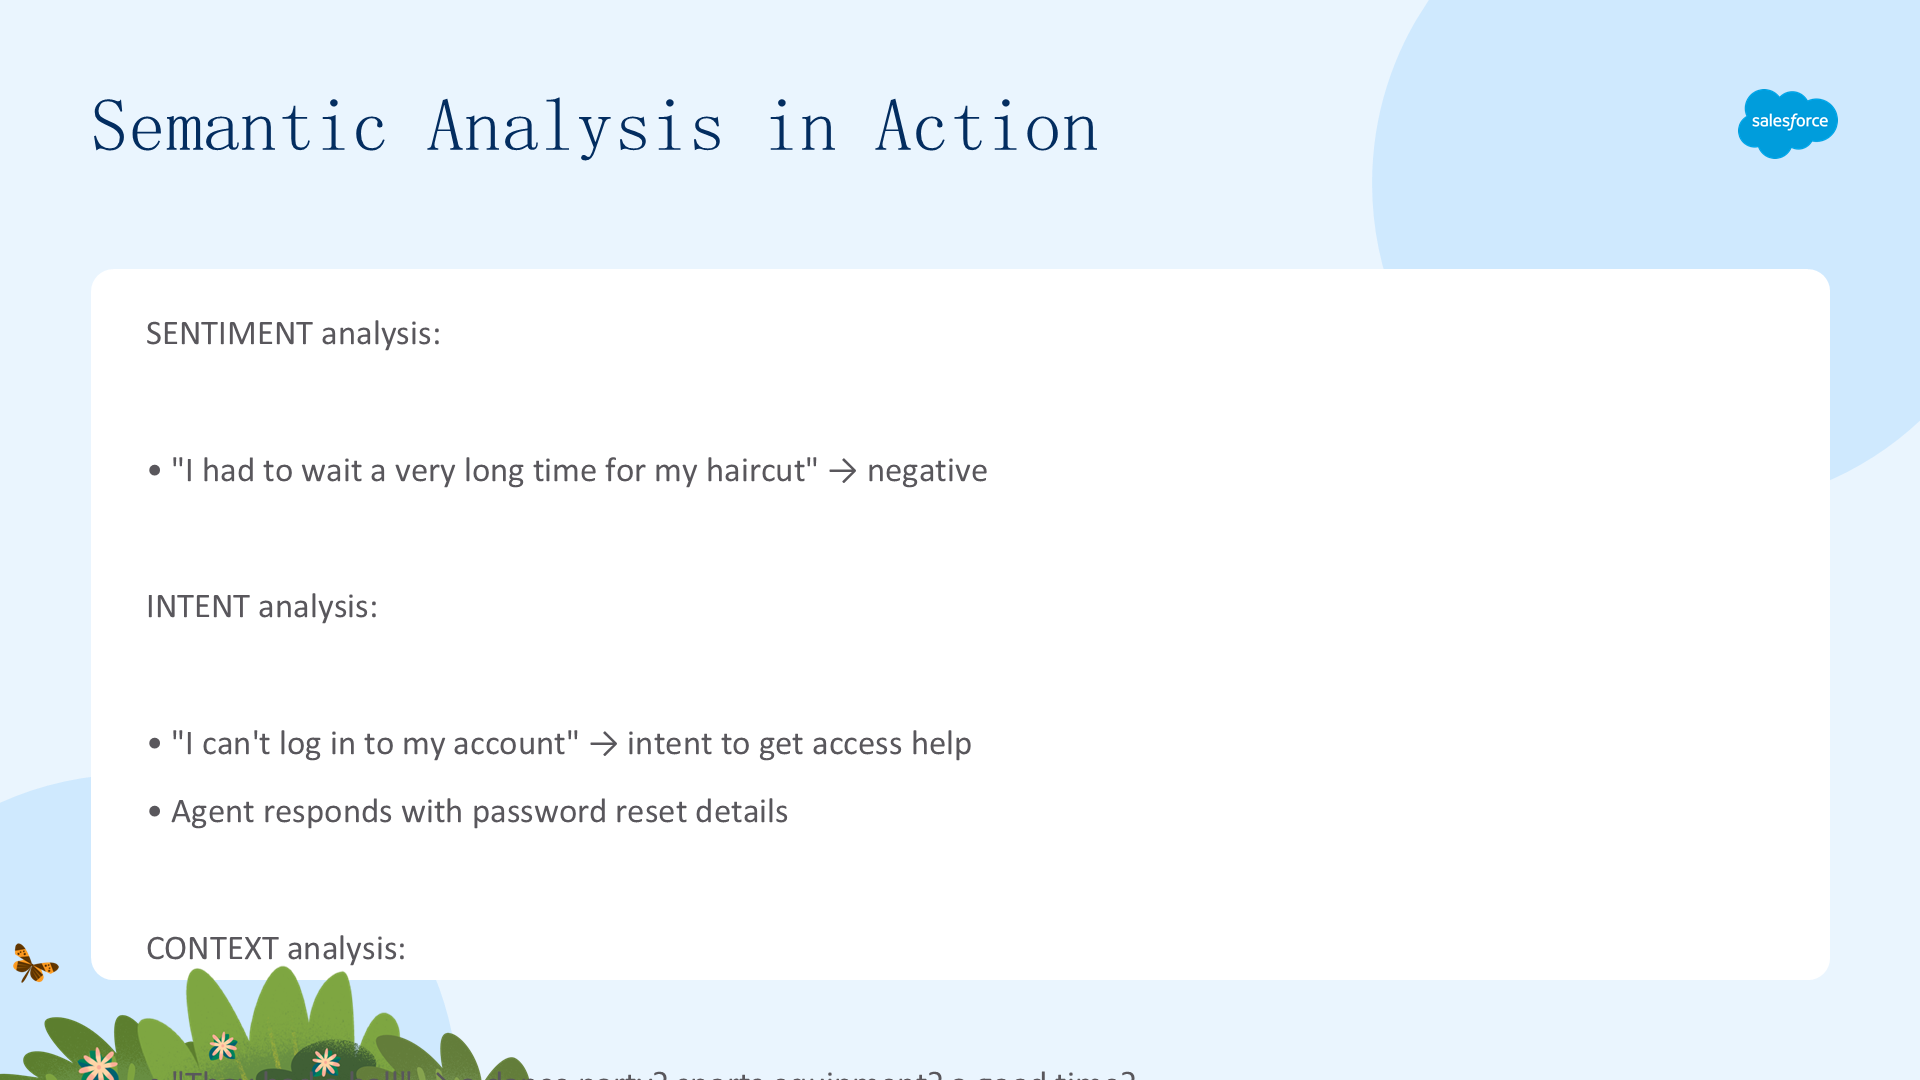
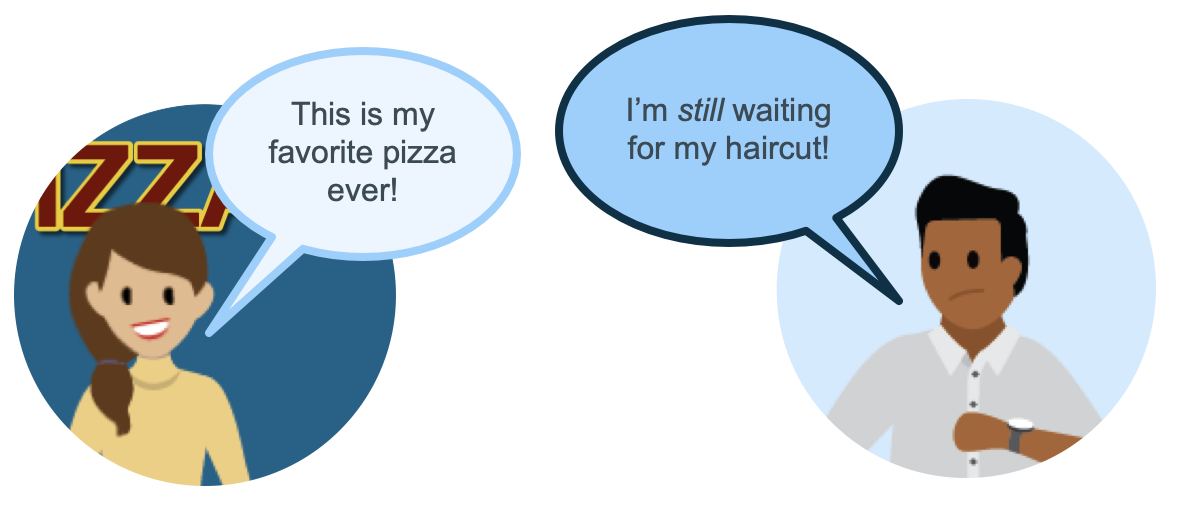
情感分析(Sentiment analysis):判断一段文本(句子、社交媒体帖子、评论、推文)表达的是正面、负面还是中性情绪。例如,判断"我理发等了好久"这条服务评论是负面。情感帮助企业了解人们对产品、服务或体验的感受。
意图分析(Intent analysis):帮助理解某人基于其所说或所写想要什么——就像解读词语背后的目的或意图。例如,某人向客服代理输入"我无法登录账户",意图分析会识别其意图是获取账户访问帮助,代理可能回复重置密码等建议。AI 助手常用意图分析理解用户请求并提供恰当回复。
语境(话语)分析(Context/discourse analysis):自然语言高度依赖语境,陈述的解释可能因情境、细节和交流双方的共同理解而变化。语境分析理解周边信息来解读文本。例如,"They had a ball"——语境分析可通过考虑之前的对话或话题,判断是"舞会"、"球类器材"还是"玩得很开心"。
这三种分析技术在从文本和语音数据中提取有价值洞察方面发挥重要作用,创造更复杂、准确的理解和互动。
总结
在本模块中,你从高层次了解了 NLP(以英语为背景)。迄今为止,NLP 研究大多用英语进行,但也有大量针对与英语结构差异很大的语言(如西班牙语、法语、波斯语、乌尔都语、中文和阿拉伯语)的研究。
NLP 是 AI 中发展非常迅速的领域,其进步正快速带来更复杂的语言理解、跨语言能力以及与其他 AI 领域的集成。