一、探索生成式 AI 的能力
学习目标
完成本单元后,你将能够:
- 描述生成式 AI 模型相比其他模型的特性
- 定义 AI 语言模型的关键词汇
- 描述使用语言模型的生成式 AI 能力
聚光灯下的人工智能
媒体近来热议人工智能(AI),几乎让人应接不暇。但为什么兴趣突然激增?AI 并不新鲜,很多企业多年来一直在某种程度上使用 AI。这次对 AI 的突然关注,很大程度上归功于 ChatGPT——第一个被广泛宣传、能做其他聊天机器人做不到之事的 AI 聊天机器人。
ChatGPT 中的 GPT 代表 Generative Pre-trained Transformer(生成式预训练 Transformer)。GPT 是一种叫神经网络的 AI 模型,能回应自然语言问题或请求,回应就像人写的。当 ChatGPT 等 GPT 向公众发布时,人们第一次亲身体验与计算机对话的感觉——令人惊讶、诡异又引人共鸣。
能进行自然对话的 AI 显然与过去不同。有些 AI 模型能产生前所未有的文本、图像和声音——这种 AI 被称为生成式 AI(generative AI),它在工作内外都蕴含着巨大的变革潜力。
语言模型的可能性
生成式 AI 看似是炙手可热的新事物,但实际上研究者训练生成式 AI 模型已有数十年。你可能还记得 2018 年 Nvidia 推出的能生成逼真随机人脸图像的 AI 模型——生成式 AI 正慢慢进入公众意识。
当研究者致力于能生成特定图像的 AI 时,另一些人专注于语言相关的 AI,训练 AI 模型执行各种涉及文本解读的任务。例如,把产品评论分类为正面、负面或中性——这需要理解词语在日常中的组合方式,是自然语言处理(NLP)的典型例子。
一些执行 NLP 的 AI 训练在海量数据(真实人类写的文本样本)上,互联网数十亿网页是绝佳的样本来源。因为这些 AI 模型训练在如此庞大的数据上,被称为大语言模型(LLM,Large Language Models)。LLM 以惊人的细节捕捉人类花多年学习的语言规则。
摘要
如果给你一个句子,你理解所有词如何组成一个观点,就能改写它表达同样的意思。AI 模型虽然不懂句法,但它们从训练的海量数据中学习识别和应用句法模式,知道哪些词可以替换,像人类一样重新组合句子。把一整段压缩成一两句话,就是另一种"重混"。
这种 AI 辅助的摘要在现实中非常有用:从一小时的录音创建会议记录、写科学论文的摘要——它是终极的"电梯演讲"生成器。
翻译
LLM 就像"语言如何把词组织成想法"的规则集合。每种语言有自己的规则——英语通常形容词在名词前,法语则相反。AI 翻译器学习两套规则,做句子"重混"时用第二套规则表达同一想法,就得到出色的翻译。
编程语言也是语言,有自己的一套规则,所以 AI 能把松散的指令翻译成实际代码——一个"口袋程序员"能为很多人打开大门。
纠错
即使最有经验的作家也会偶尔犯语法或拼写错误。现在 AI 能检测(有时自动纠正)任何问题。此外,在听人说话时修补错误也很重要——你可能因环境嘈杂漏听一两个词,但会用上下文填补空白。AI 也能做到这一点,让语音转文本任务(如字幕)更加准确。
问答
这是把生成式 AI 推向聚光灯的任务。GPT 等 AI 能解读问题或请求的意图,然后基于请求生成大量文本。
例如,你可以请 GPT 用一句话总结莎士比亚三大最受欢迎作品,得到:《罗密欧与朱丽叶》——两个来自敌对家庭的年轻恋人,他们的爱情最终导致不幸早逝的悲剧;《哈姆雷特》——一个被父亲鬼魂纠缠、在复仇与生死存在之问中挣扎的王子;《麦克白》——一个被妻子野心驱使的贵族,走上血腥谋杀夺取王位的野心与道德沦丧的惊悚剧。
然后你可以像与语文老师对话一样继续追问更多关于哈姆雷特的信息——这种交互是"用简单请求获得即时信息"的绝佳例子。
引导式图像生成
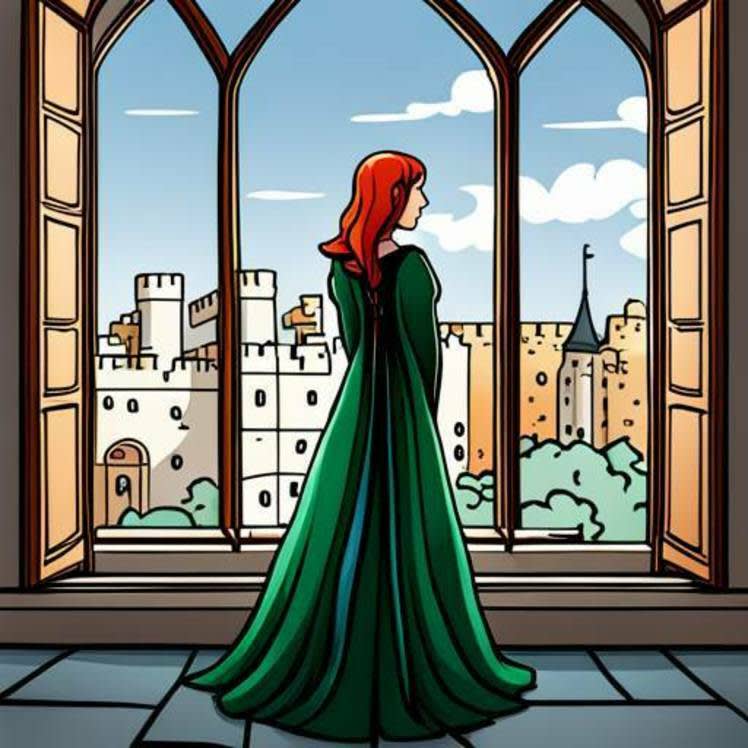
LLM 可以与图像生成模型配合使用——你描述想要的图像,AI 就尝试为你生成。例如,请求"朱丽叶站在古堡窗前的 2D 线稿画"。因为互联网上有大量罗密欧与朱丽叶的描述和图像,AI 生成器无需更多信息就能猜出合适的图像。
与引导式图像生成相关,一些 AI 模型还能给现有图像添加新内容——比如扩展图片边框,让 AI 根据原图上下文绘制可能出现的内容。
文本转语音
类似于 AI 能把一串文字转成图片,也有 AI 模型能把文本转成语音。有些模型能分析一个人说话的音频样本,学习其独特的语音模式,并在把文本转换为新音频时重现这些模式——对普通听众来说,很难分辨差异。
这些只是 LLM 用来创造新文本、图像和声音的几个例子。几乎任何依赖理解语言工作原理的任务都能被 AI 增强——它是工作与娱乐都适用的强大工具。
令人印象深刻的预测
现在你了解了生成式 AI 的能力,有一点必须说清楚:生成式 AI 生成的文本,其实只是另一种形式的预测——不是预测房价,而是预测可能对读者有意义、相关的词序列。
这些预测确实令人印象深刻,但它们并不代表计算机在"思考"。它对你问的话题没有观点,也没有自己的意图或欲望。如果它听起来像有观点,那是因为它在对你期望的回应做最佳预测。例如,问某人"你更喜欢咖啡还是茶?"会引发某种预期回应——训练有素的模型能预测出回应,即使计算机"想喝什么"毫无意义。
二、理解生成式 AI 的技术生态系统
学习目标
完成本单元后,你将能够:
- 识别推动生成式 AI 快速发展的关键组件
- 描述构成生成式 AI 技术栈的技术类型
- 描述企业对生成式 AI 的常见担忧
加速生成式 AI 训练
生成式 AI 在看似很短的时间内获得了大量能力,这种惊人的改进速度主要归因于三大因素:
- 海量训练数据的可用性:互联网数十亿网页是绝佳的写作样本来源。
- 更好的训练:研究者设计使用复杂数学训练 AI 模型的神经网络。2017 年,Google 研究者发表了改变游戏规则的论文,提出新架构 transformer——它能识别词之间的重要关系,无论它们在文本块中相距多远。
- 计算能力:transformer 架构依赖许多独立、并发的计算——并行计算(parallel computing)让一个处理器做第一个计算的同时,另一个处理器同时做第二个,大幅减少训练时间。
这三大因素——数据、架构、计算——汇聚成训练强大 LLM 的恰到好处的条件。
新兴生态系统
现在互联网上已有数百个网站可以体验生成式 AI。当你访问其中一个网站时,你正处于技术冰山的一角,而这些技术可以来自许多不同的来源。
这个蓬勃发展的科技公司生态系统在过去几年里以惊人的速度增长。有些公司专注于某一特定细分——比如基础模型领域的公司可能专注于训练更新、更好的模型以差异化;另一些公司则创建跨越技术栈多层的解决方案,为应用自研专有 LLM。
鉴于对 AI 技术前所未有的需求,企业在 AI 技术栈的多个层面都有巨大的机会留下印记。
生成式 AI 的常见担忧
生成式 AI 正在引领我们与计算机交互方式的诸多变革。与任何颠覆性技术一样,理解其局限和值得担忧之处很重要。这些担忧可能产生法律和伦理影响,因此需要考虑并监控使用生成式 AI 时可能出现的危害。以下是几个需要了解的重要担忧。
幻觉
记住,生成式 AI 其实是另一种形式的预测,而预测有时会出错。生成式 AI 中偏离事实、脱离依据的预测被称为幻觉(hallucinations)。它们发生的原因有几个,比如训练数据不完整或有偏见,或模型设计不佳。对任何 AI 生成的文本,务必花时间验证内容的事实正确性。
数据安全
企业在生成式 AI 生命周期中有两个节点可能共享专有数据:一是在微调基础模型时,二是在实际使用模型处理含敏感数据的请求时。提供 AI 服务的公司必须证明信任至上、数据始终受保护。Salesforce 使用 Einstein 信任层在 AI 交互中保护客户和公司数据。
抄袭
LLM 和用于图像生成的 AI 模型通常训练在公开可用的数据上,因此总有可能模型会复制训练数据的措辞或风格。开发基础模型的企业必须采取措施在生成内容中增加变体以防抄袭,也可能需要按内容创作者的要求编辑训练数据、删除样本。
欺骗
如今比以往更容易创建可信的在线身份或商业网站,配以 AI 生成的图像。假用户和假网站能以非常逼真的方式与真实用户(以及其他假用户)互动,这让企业难以识别推广自身机器人内容的机器人网络。
可持续性
训练和运行 AI 模型所需的计算能力是巨大的,可能转化为碳排放、水资源消耗和其他环境影响。随着模型变大,碳足迹也在变大。Salesforce 正致力于确保 AI 可持续——开发高效的 AI 模型、以透明引领,并通过可再生能源和现代化电网基础设施实现电力部门脱碳。
总结
生成式 AI 能够帮助企业和个人完成各种基于语言的任务。海量数据、巧妙的 AI 架构和巨大计算能力的汇聚,加速了生成式 AI 的发展和 AI 生态系统的增长。