一、开始使用 Agent Monitoring
通过 Agent Monitoring 衡量并改进结果
Agentforce Monitoring 是一套工具集,让你能够深度洞察 AI Agent 的交互行为。它包含两大核心工具:
- Agent Analytics:提供对 Agent 会话的广泛视图,帮助你洞察 Agent 在生产环境中的表现。Agent Analytics 通过展示交互延迟、使用模式以及整体质量评分和成功率等性能指标,揭示 Agent 的表现。它帮助回答诸如「我的 Agent 是否按预期工作?」以及「我可以在哪里、如何改进它?」等问题。
- Sessions & Intents:提供意图级别的细节以便更深入地检查。LLM 将跨会话的相似用户目标分组为「意图(intent)」。你可以超越整段会话的摘要,找到 Agent 回答不准确、误导、偏离主题,或配置的操作未按预期运行的情况。
当你的 Agent 处于活跃状态时,系统会收集关于它们在做什么以及做得如何的全面信息。你可以利用这些工具和数据进行以下操作:
- 发现 Agent 的趋势和模式
- 筛选并深入到具体会话,包括那些导致结果不佳的会话
- 审计和调试 Agent 的行为
- 发现并分类导致结果不佳的原因
- 确定行动项以解决根本原因
在实现并测试你的改进之后,你可以部署并监控一个改进版的 Agent,以更高的用户满意度交付更好的结果。
Agent 开发生命周期(ADLC)
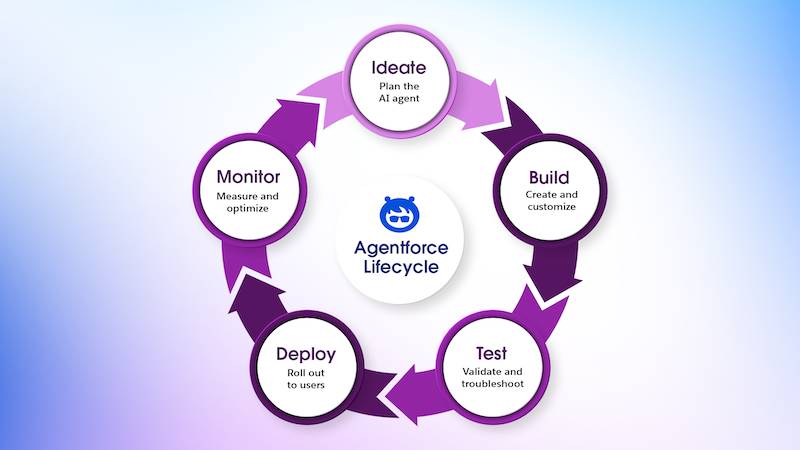
ADLC(Agent Development Lifecycle,Agent 开发生命周期)以迭代循环的方式依次经过 构思(Ideate)、构建(Build)、测试(Test)、部署(Deploy) 和 监控(Monitor) 五个阶段,实现 Agent 的持续改进。
一个成功的 AI 解决方案始于构思阶段,在此阶段要确立可衡量的、以结果为导向的目标(即 KPI)来衡量成功。例如,对于服务型 Agent,你的业务目标可能是最大化案例转移率(超过 80%)、最小化人工升级率(低于 25%),以及最小化放弃率(用户放弃 Agent,低于 5%)。这些业务目标会指导 ADLC 的所有阶段:如何设计和构建 AI 解决方案、部署前如何测试,以及上线后如何监控。
可观测性(Observability) 是衡量和理解 Agent 实际行为的实践,尤其适用于测试和监控阶段。在这两个阶段,你都需要:观察 Agent 的行为、按目标衡量结果、将结果与目标对比、必要时采取行动改进 Agent。两者之间的重要区别在于:
- 测试帮助你观察 Agent 在「实验室」中的表现,用精心设计的测试用例和测试数据,进行预览和大规模批量测试,以便在发布到生产环境之前发现、诊断并修复问题。
- 监控让 Agent 暴露在真实世界的条件下,以多样且不可预期的方式运行。你可以随时间观察 Agent,发现趋势和有意义的模式,从而判断需要在哪些方面让 Agent 更具韧性、更可靠、更有效地产生你想要的结果。
在监控阶段,Agent 的活动会在多个维度被观察、衡量和计算,包括:
- 有效性(Effectiveness),如案例转移率(%)
- 使用情况(Usage),如独立会话数
- 质量(Quality),如知识检索评分
- 健康度(Health),如错误率
- 信任(Trust),如指令遵守率
- 用户满意度(User satisfaction),如点赞/点踩(仅限 Employee Agent)
- 语音(Voice),如打断率
数据收集从你在组织中开启 Agentforce Session Tracing、Audit and Feedback 以及 Knowledge/RAG Quality Data and Metrics 时开始。你还需要为各个 Agent 类型安装分析应用。所有会话中每一次轮次和事件的活动日志都会被捕获,测量和评分数据在统一的 Data 360 数据模型中被收集、计算和聚合。分析数据来自多个来源:
- 会话跟踪(Session tracing)——捕获对话过程中逐步发生的情况(输入、决策、执行的操作和输出),这些细节告诉你 Agent 为什么会以某种方式行事。
- 审计与反馈数据(Audit and feedback data),如知识检索评分。
- 信任层评分(Trust Layer scores),如毒性和指令遵守。
Coral Cloud Resorts 的 Excursion Booking Agent
和许多精品度假村一样,Coral Cloud Resorts 为希望在其入住期间探索有趣活动的客人提供全方位的短途旅行(excursion)。浮潜和水肺潜水等水上活动最受欢迎,此外还有骑行和文化之旅等陆地探险。Coral Cloud Resorts 的短途旅行如此受欢迎且利润丰厚,以至于短途旅行部门忙得不可开交,无法满足需求。
Coral Cloud Resorts 的商业智能总监 Alex Wu 推动了他的公司引入 Agent 的决定。他使用 ADLC 框架,规划、设计、构建、测试并部署了一个全新的 Excursion Booking Agent,用于处理和扩展短途旅行的客户服务。该 Agent 负责处理信息咨询并管理预订。
在规划阶段,Alex 确立了评估新 Agent 的首要目标:
- 将信息咨询和预订请求转移 50%。
- 将升级率从 100%(没有 Agent)降低到 50%。
通过提供一个具有对话界面的易用系统,Alex 希望为客人带来更好的结果,并为度假村增加预订量。现在它已经在生产中运行,他迫切希望监控该 Agent 与用户的互动表现。我们将跟随 Alex,看看他如何使用分析来监控他的 Agent,并将这些信息与其他工具结合来改进 Agent 性能。
二、监控 Agent 指标与评分
导航 Agent Analytics
Agent Analytics 提供可视化和下钻工具,帮助你识别和调查所有 Agent 会话中有意义的趋势和模式。你可以探索不同粒度的细节,从高度细化的数据到聚合洞察,再到 Agent 性能随时间变化的趋势分析。
要启动 Agent Analytics,请按以下步骤操作:
- 从 App Launcher 中搜索并选择 Agentforce Studio。
- 选择 Agents。
- 在 Explorer 的 Observe & Optimize 下,选择 Analytics。
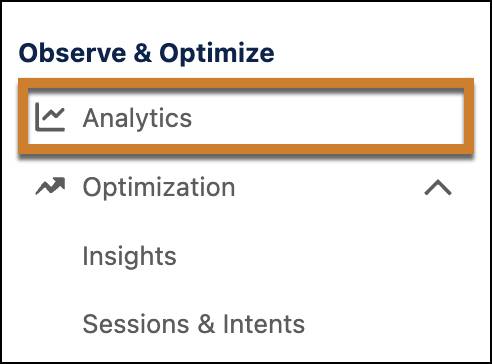
Observe & Optimize 区域包含:
- Analytics:打开所选 Agent 应用的性能仪表板。
- Sessions & Intents(展开 Optimization):打开一个独立会话表格,用于转录审计、意图比较和打标签。
选择 Agent 类型后,Agent Analytics 仪表板会显示该类型的指标。仪表板由 Tableau Next 驱动,指标可能因 Agent 类型而异。下面是服务型 Agent(Service Agent)的仪表板示例。
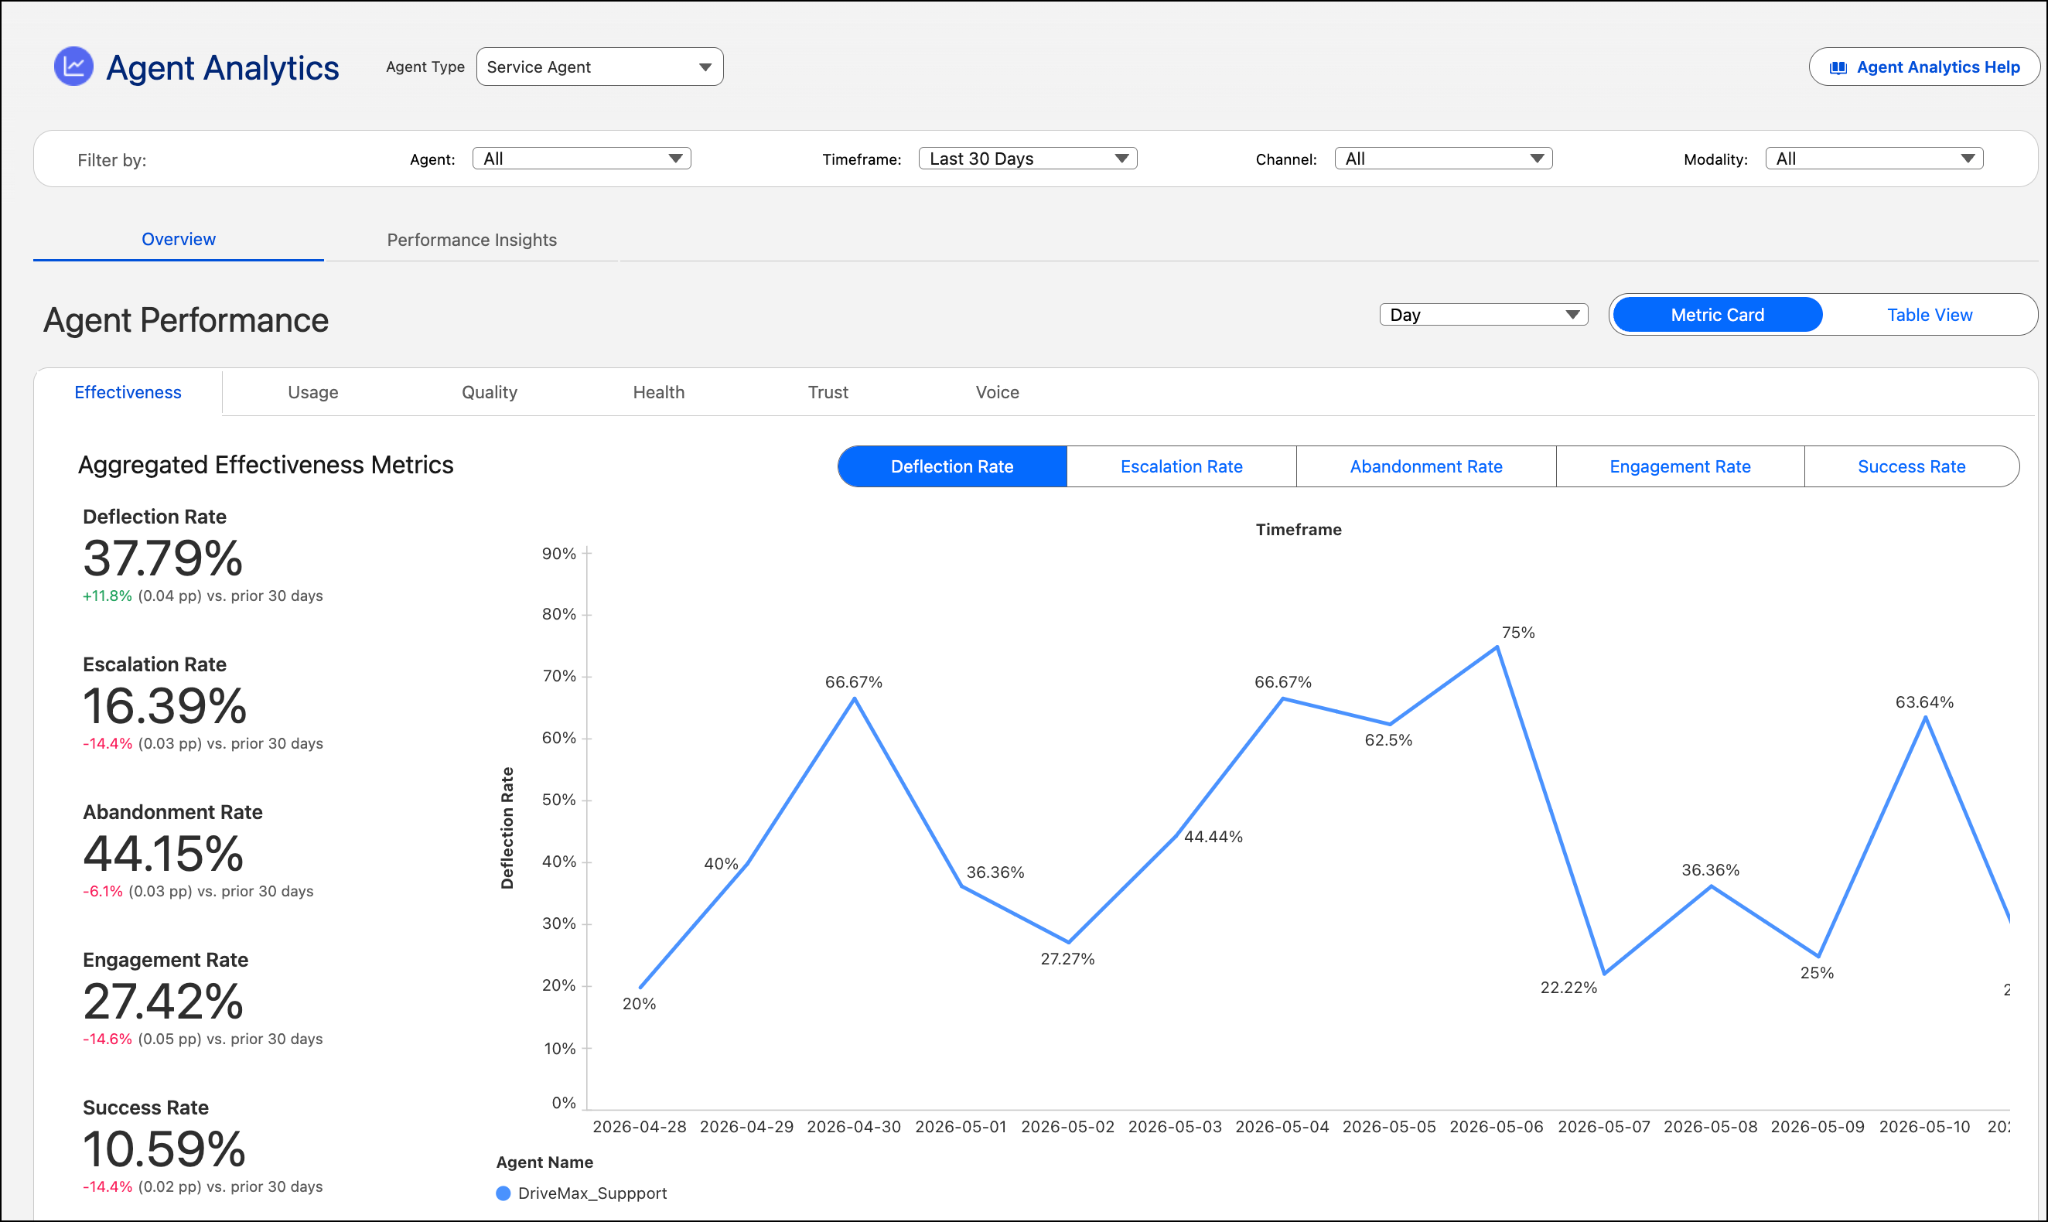
仪表板顶部的过滤栏用于限定数据范围,让你聚焦在想要探索的区域:全部 Agent 或某个特定 Agent、要显示的时间窗口、渠道,以及模态(例如文本、语音或两者)。

Overview(概览) 标签页展示头部 KPI、环比趋势卡片和结果图表,让你一览整体情况,快速了解聚合的 Agent 性能指标。
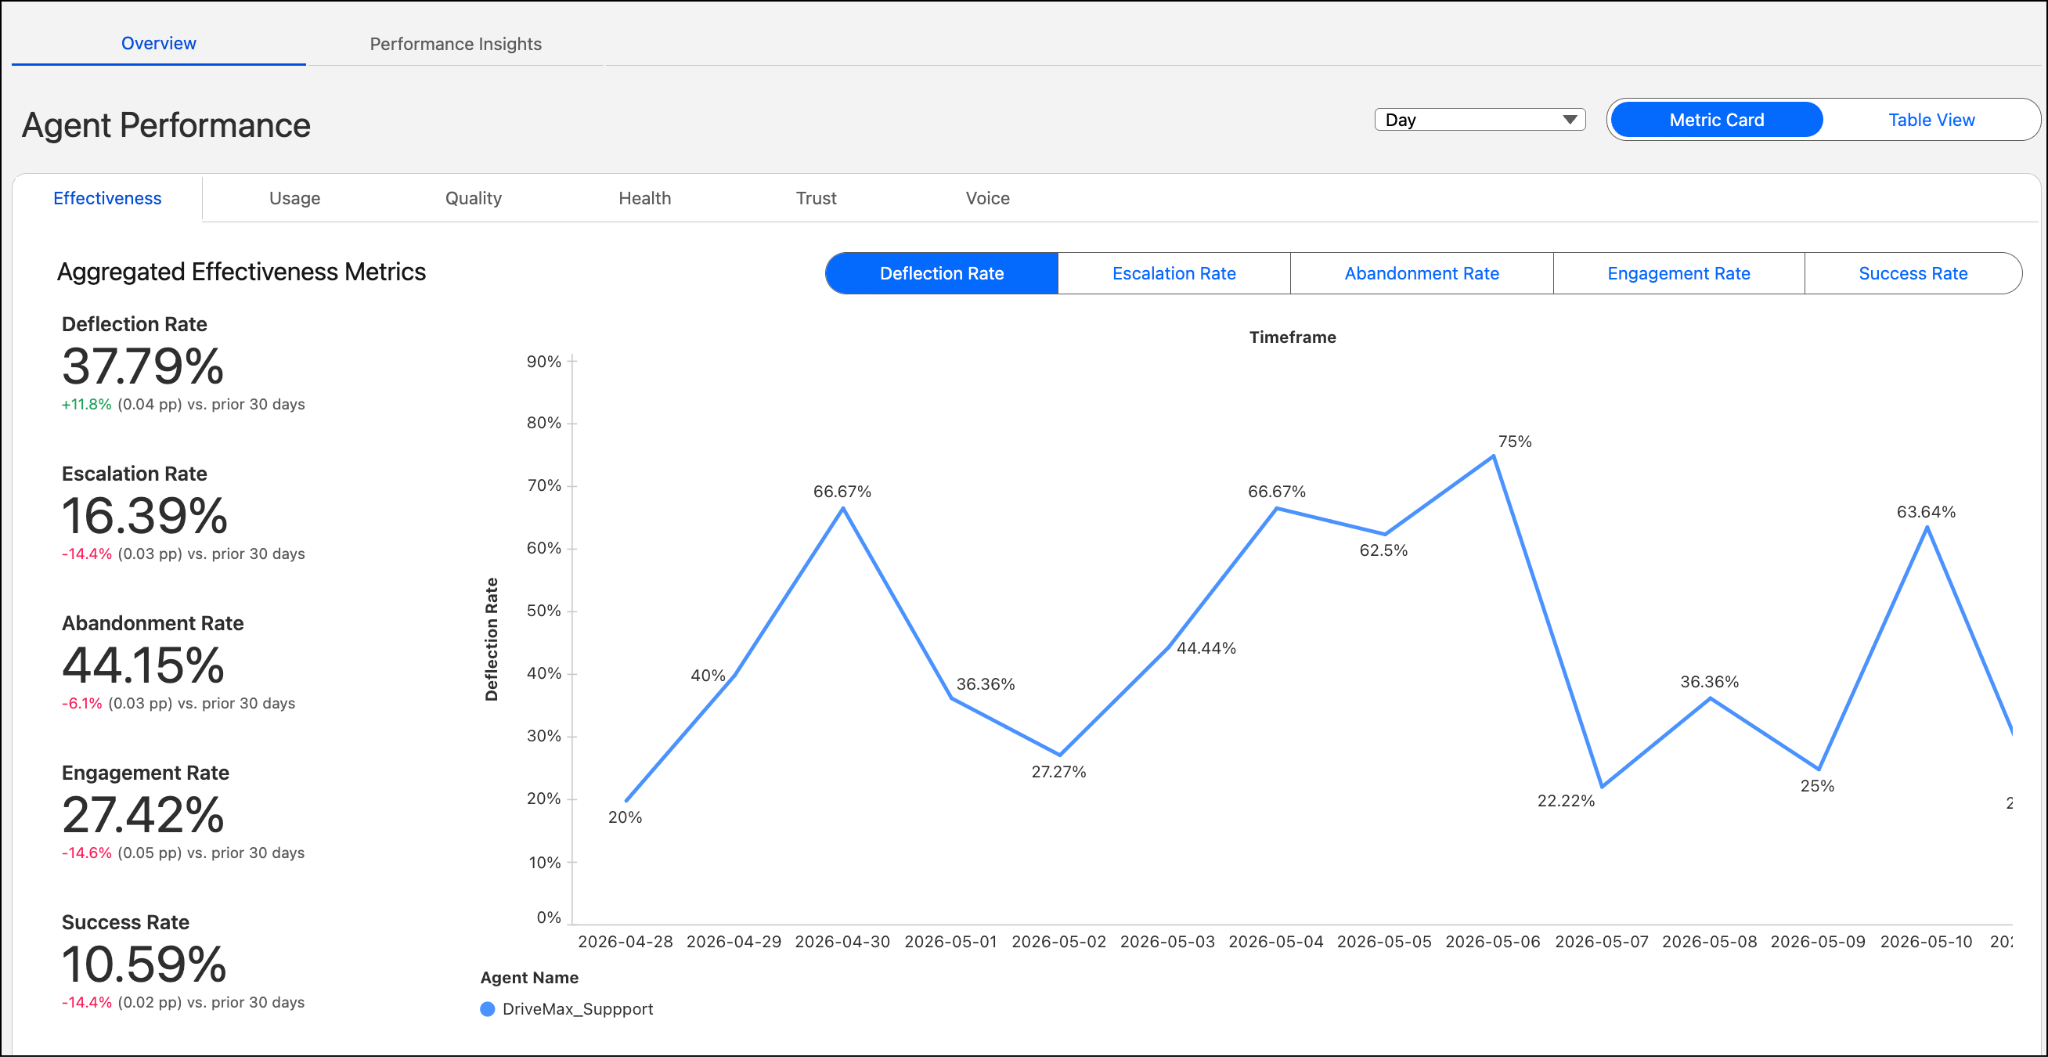
分析数据按维度(dimension)分类。选择一个维度标签页(如 Quality 或 Health),即可查看其 KPI 集合和图表。
探索有效性(Effectiveness)指标 —— 选择 Effectiveness 标签页,可以看到带有环比变化指示的 KPI 卡片,以及多 Agent 趋势折线图和会话结果堆叠柱状图:
- 转移率(Deflection Rate):未升级到支持代表或其他 Agent 而结束的会话占比。
- 升级率(Escalation Rate):升级到支持代表或其他 Agent 的会话占比。
- 放弃率(Abandonment Rate):超时或未产生互动而结束的会话占比(默认超时:2 小时)。
- 互动率(Engagement Rate):用户收到与 Agent 触发操作相关的回复的会话占比。仅当至少触发了一个操作时,会话才被计为「已互动」。
- 成功率(Success Rate):包含操作步骤且无错误完成的互动占比。
- 任务解决率(Task Resolution Rate):被信任层任务解决检测器评估为「完全解决」的会话占比。
继续向下滚动,你会看到以堆叠柱状图形式呈现的会话结果聚合统计。
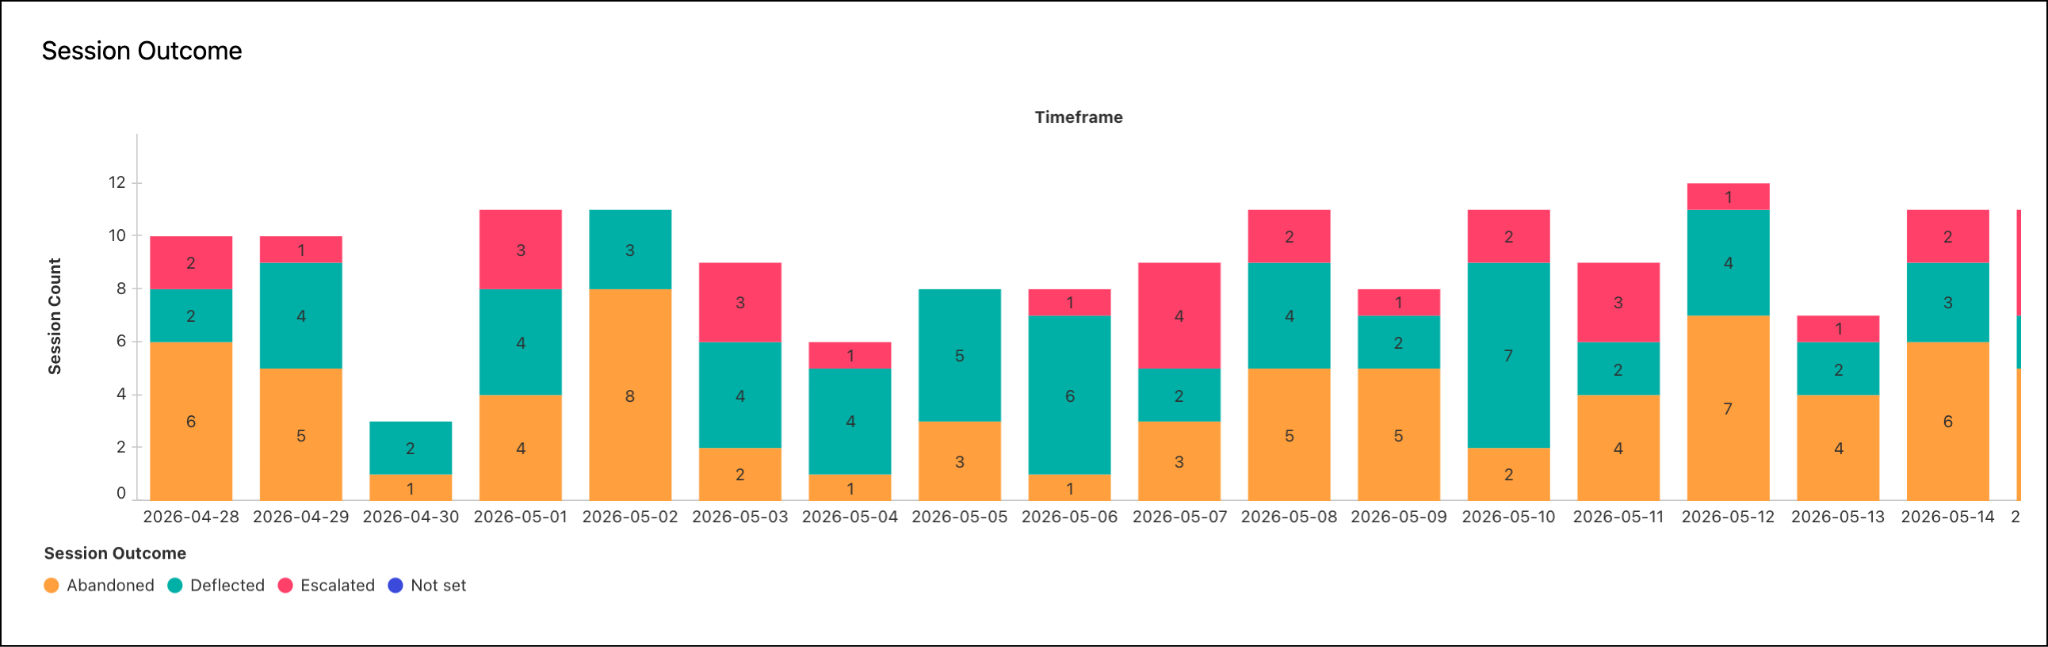
- 已转移(Deflected):应用户请求结束(用户已解决)。
- 已升级(Escalated):转交给客户服务代表或其他 Agent。
- 已放弃(Abandoned):超时或中途退出。
- 不明确(Ambiguous):无法清晰归类。
你可以选择 Metric Card 查看磁贴布局(带图形和细节的大卡片),选择某个指标即可切换图表。
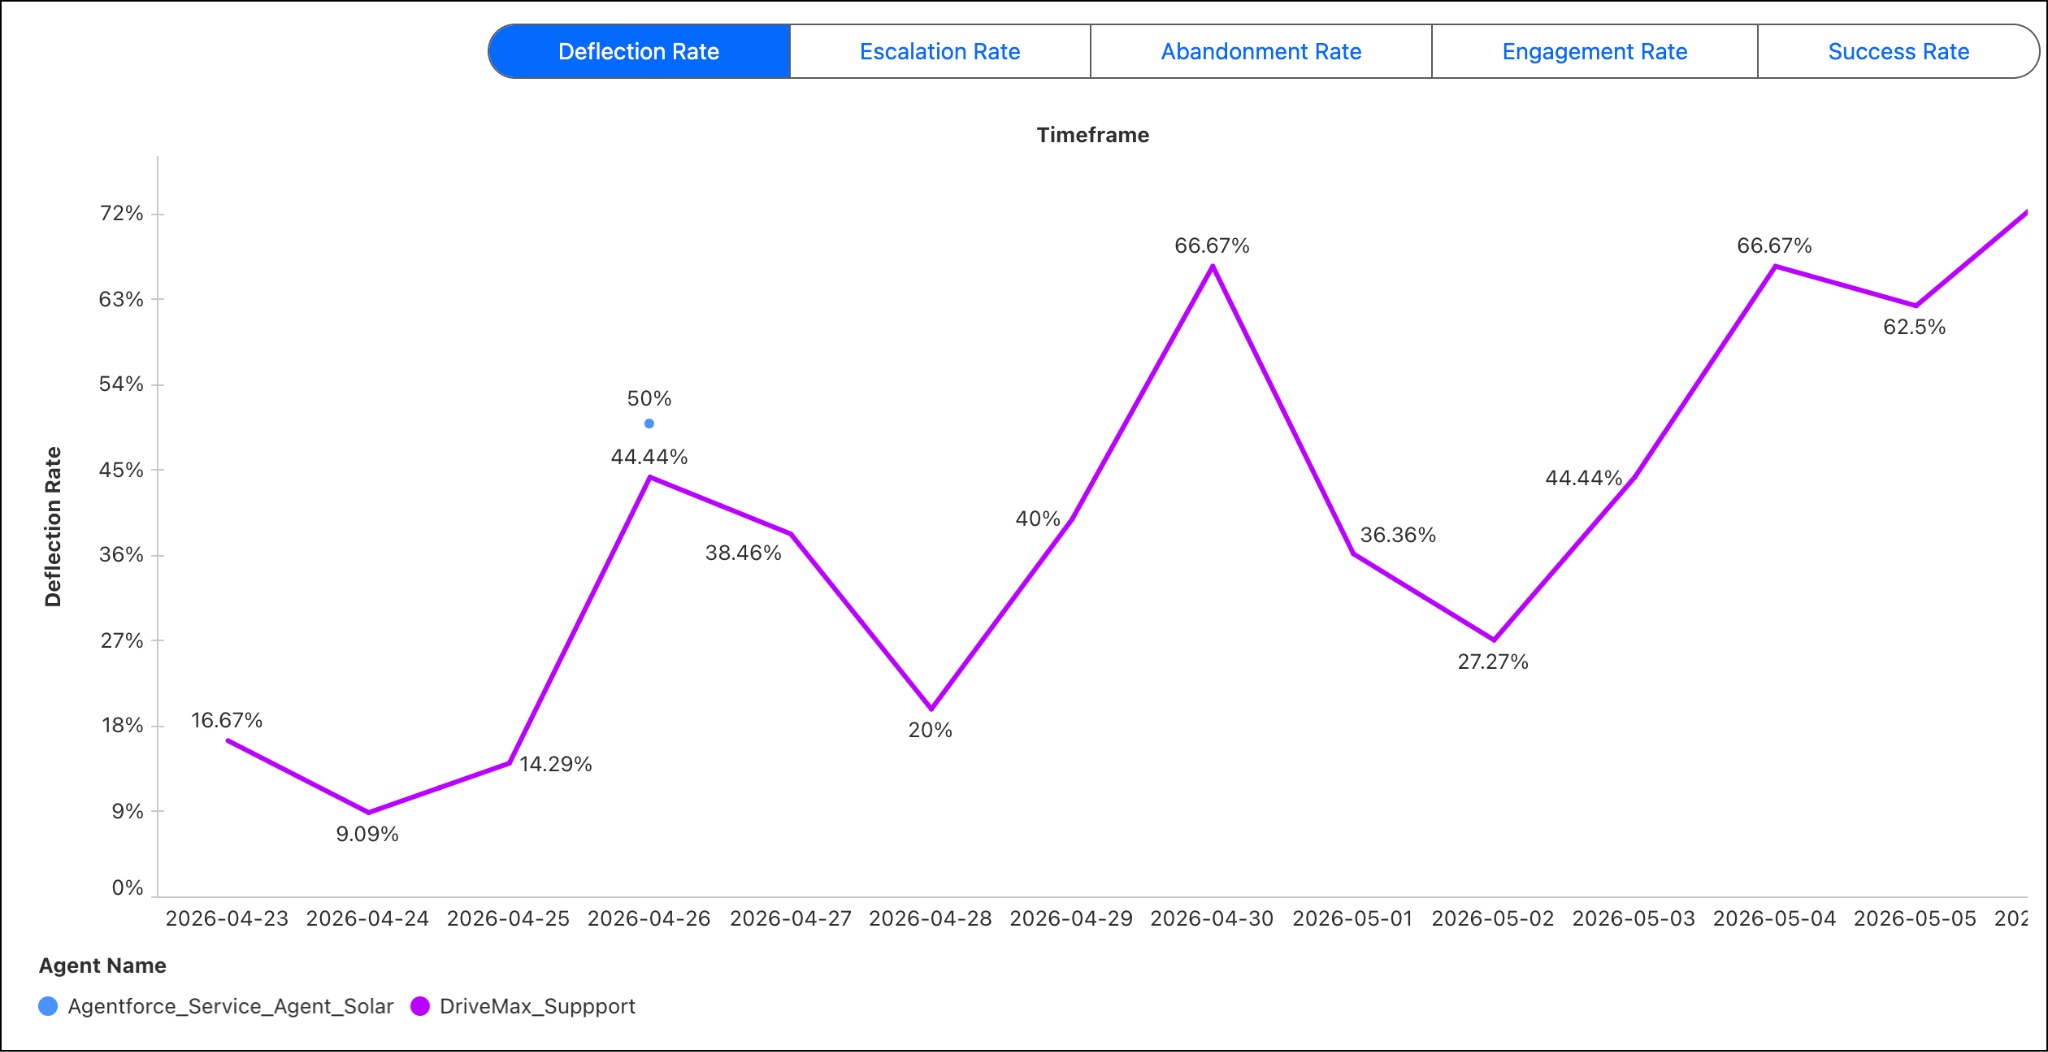
也可以选择 Table View 查看紧凑的表格布局,一次性显示所有指标。
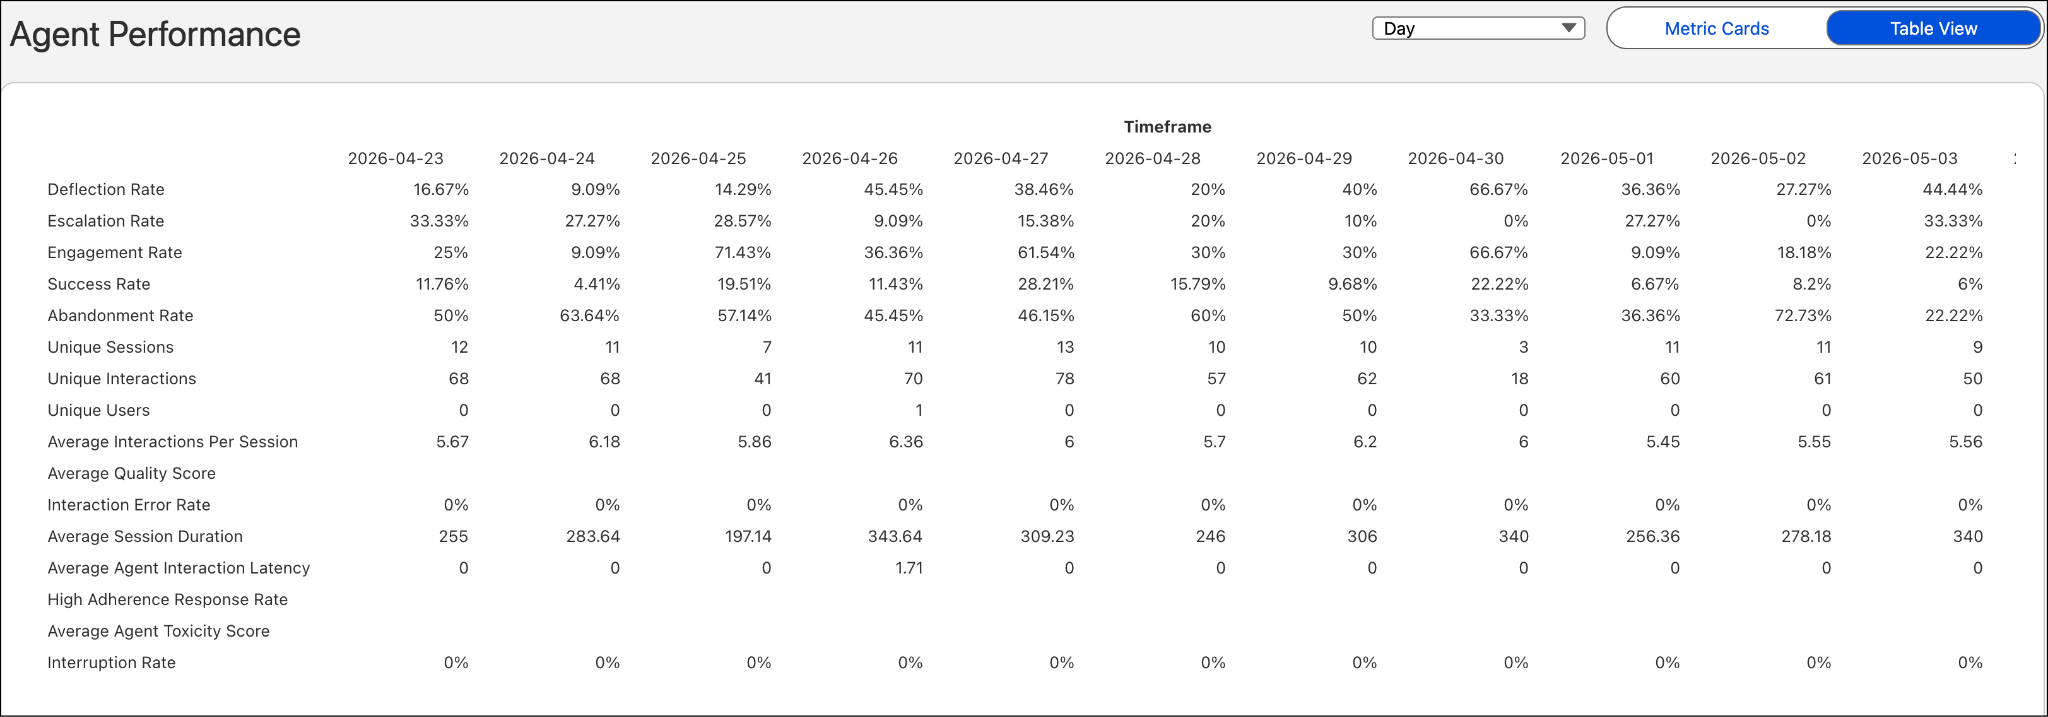
日期过滤器可以更改图表的粒度(日/周/月)。
探索使用情况(Usage)指标 —— 选择 Usage 标签页查看:
- 独立会话数(Unique Sessions):在定义的时间范围内记录的独立会话数量。一个会话包含用户与 Agent 之间的完整交流。
- 独立互动数(Unique Interactions):在定义的时间范围内记录的独立用户与 Agent 互动数量。一次互动被视为用户的一次请求加上 Agent 的一次响应。
- 独立用户数(Unique Users):在定义的时间范围内与 Agent 互动的独立用户数量。
- 每会话平均互动数(Average Interactions Per Session):每个会话的平均互动次数。
探索质量评分(Quality Scores) —— 选择 Quality Scores 标签页,查看由外部 LLM 评估器生成的维度评分。这些评分需要先在 Setup 中开启 Audit and Feedback 以及 Knowledge/RAG Quality Data and Metrics。
- 质量评分(Quality Score,1–5):Agent 响应对用户请求的整体相关性。
- 答案忠实度(Answer Faithfulness,0–1):响应与有依据的源数据(知识库文章)的贴合程度。
- 答案相关性(Answer Relevance,0–1):响应与用户问题的相关性。
- 上下文相关性(Context Relevance,0–1):Agent 是否检索到正确的数据源来回答问题。
探索健康度(Health)指标 —— 选择 Health 标签页查看:
- 错误率(Error Rate):Agent 在处理或响应过程中遇到错误的互动占比。
- 会话时长(Session Duration,秒):会话持续的时间(秒)。
- Agent 交互延迟(Agent Interaction Latency,秒):Agent 响应用户请求所需的时间。
探索信任(Trust)指标 —— 选择 Trust 标签页查看 Einstein 信任层中的评估。信任指标需要开启 Audit and Feedback 以及相关的信任层功能。
- 遵守响应率(Adherence Response Rate):指令遵守达到高遵守阈值的响应占比。
- 平均 Agent 毒性评分(Average Agent Toxicity Score,0–1):Agent 输出的平均毒性检测评分,越低越好。
语音(Voice)指标 —— 选择 Voice 标签页查看:
- 打断率(Interruption Rate):发生打断的互动占比。
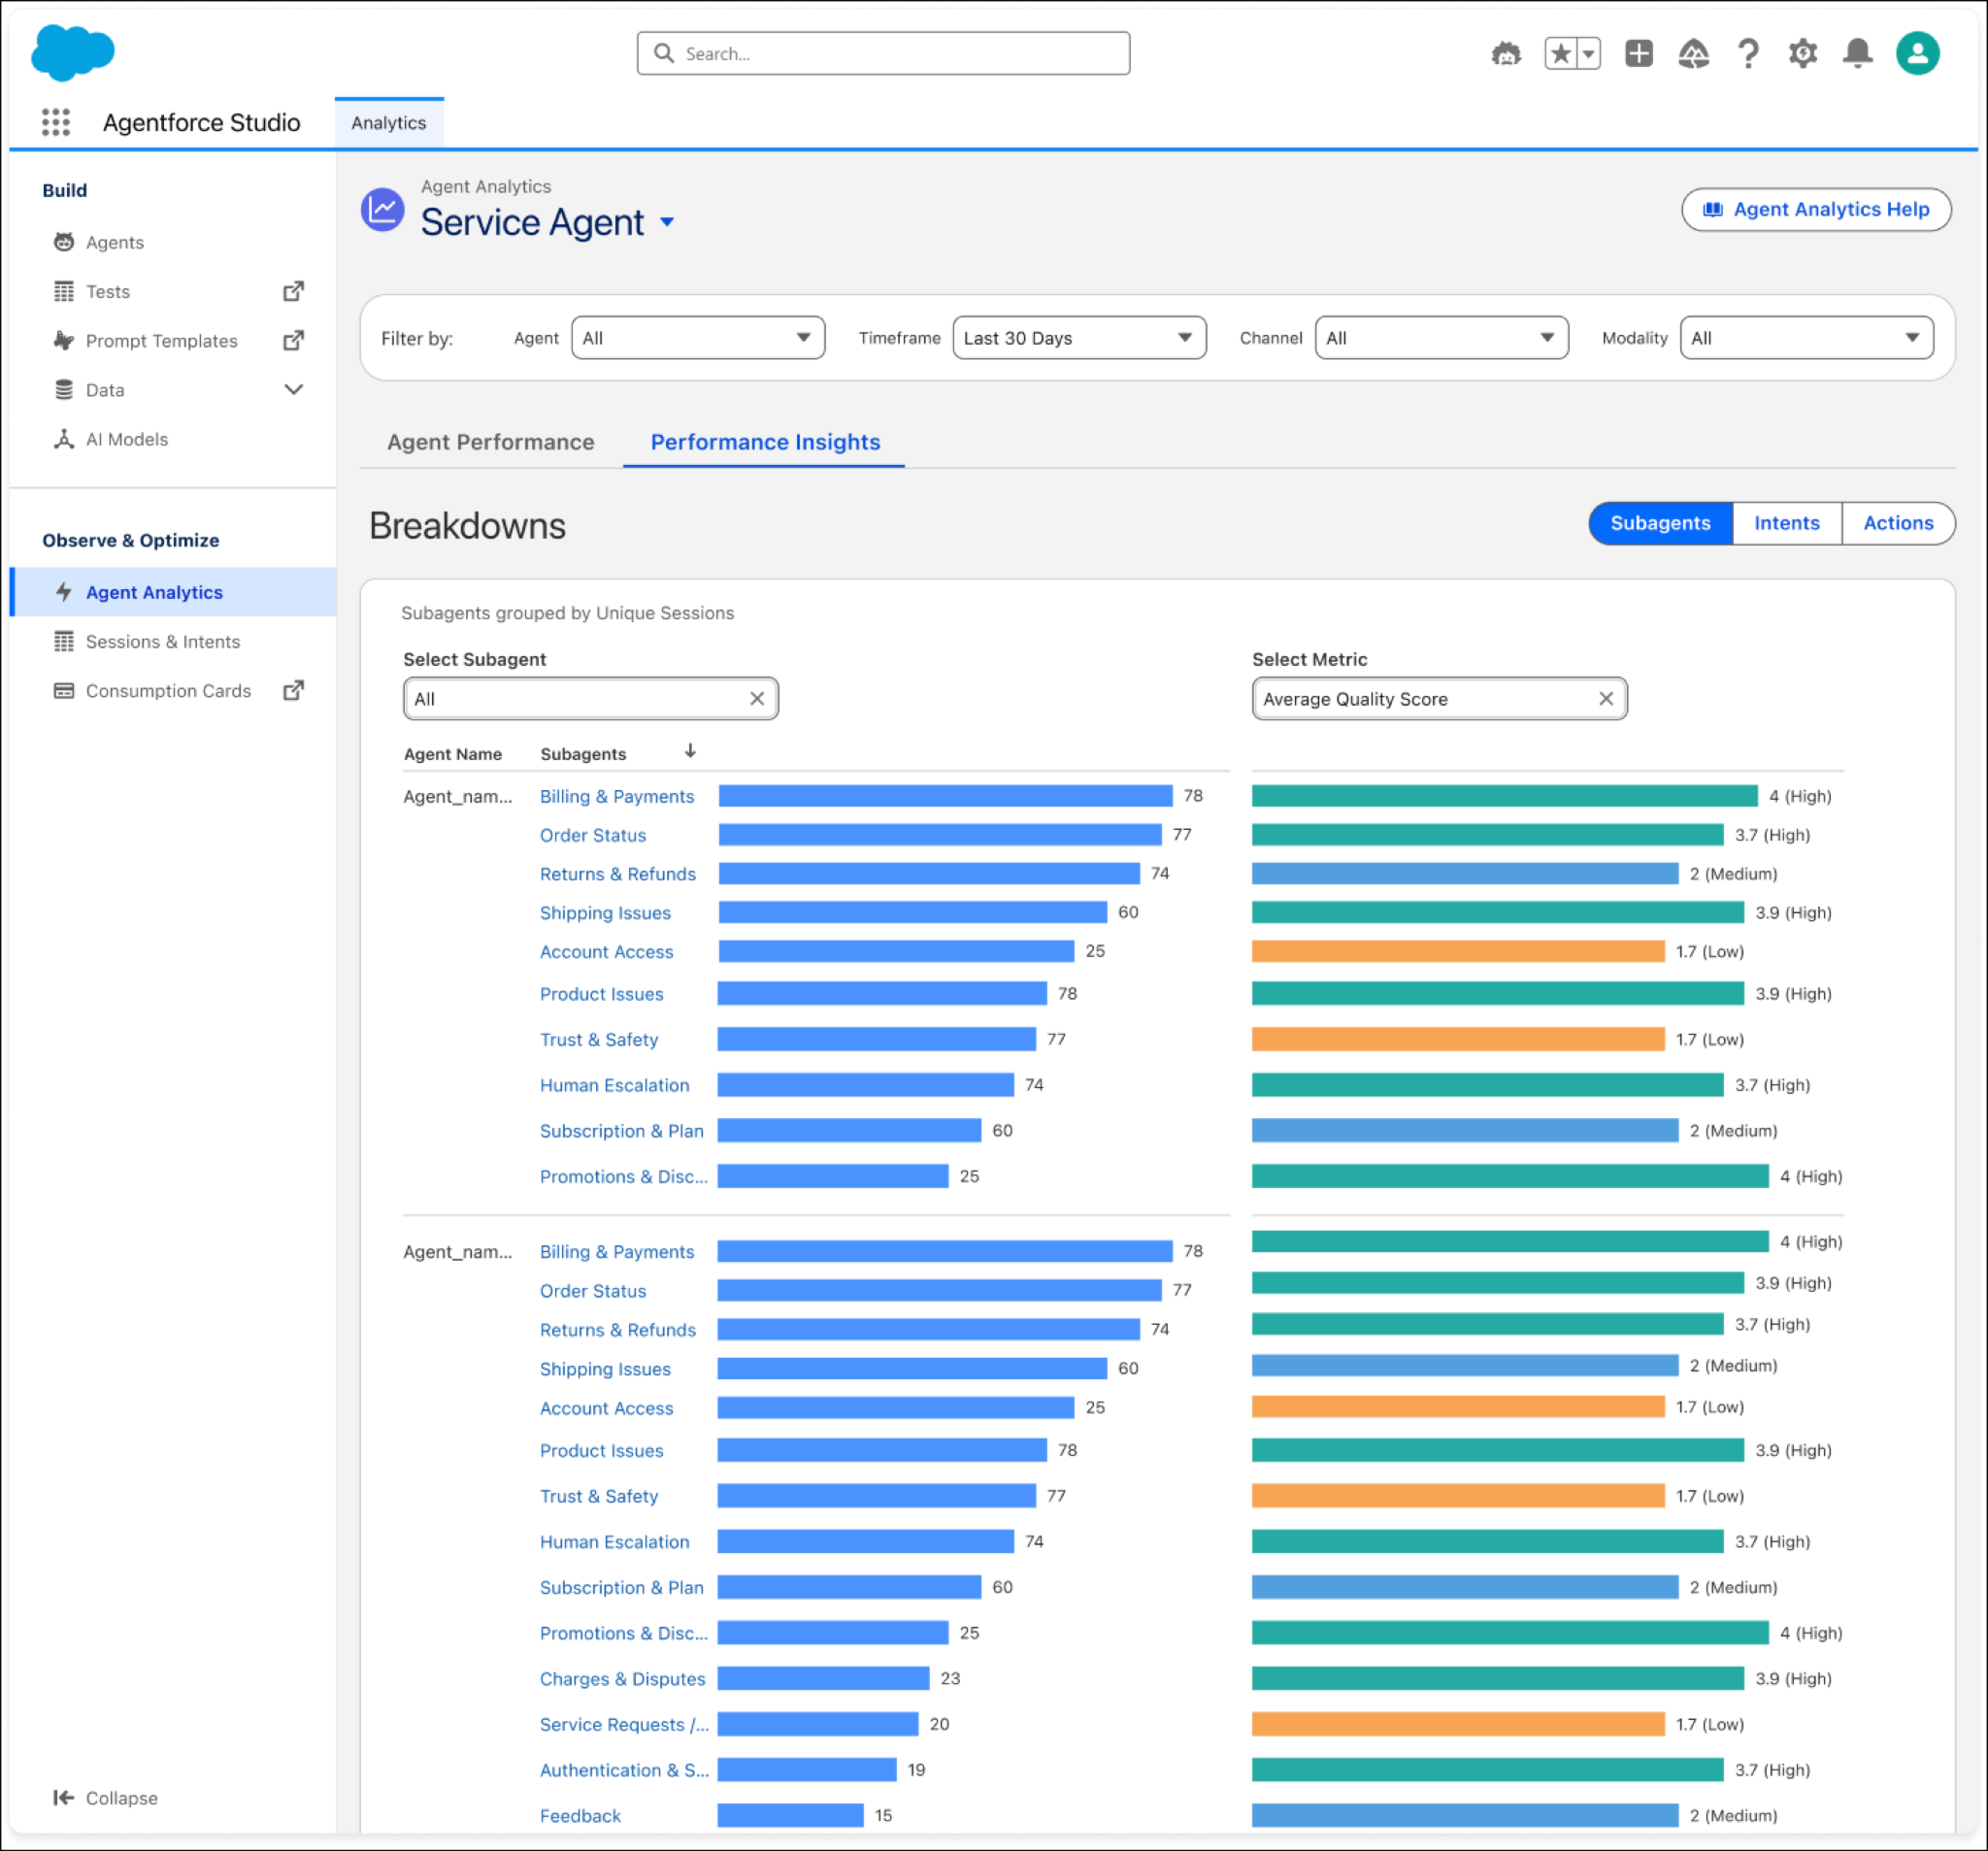
探索性能洞察(Performance Insights) —— Performance Insights 标签页让你跨细分维度比较性能,判断哪些子 Agent、意图或操作带来了好或坏的结果,用于调查哪些细分维度表现不佳。操作步骤如下:
- 选择 Performance Insights 标签页。
- 在 Breakdowns 面板中选择细分类型:Subagents、Intents 或 Actions。
- 使用 Select Subagent(或等效选择器)筛选到特定细分,或保持为 All。
- 在 Select Metric 中选择要比较的指标。
- 查看水平条形图。每一行代表一个细分维度(例如一个子 Agent,如 Billing & Payments 或 Order Status),条形长度代表指标值,颜色编码表示性能水平(绿色=良好,橙色/红色=需要关注)。
此外,在 Employee Agent 仪表板中,选择 User Satisfaction 可以查看正面用户反馈(点赞)和负面用户反馈(点踩)的计数。两项指标都展示多 Agent 趋势线,方便你跨 Agent 跟踪情绪随时间的变化。
Alex 调查 Agent 性能
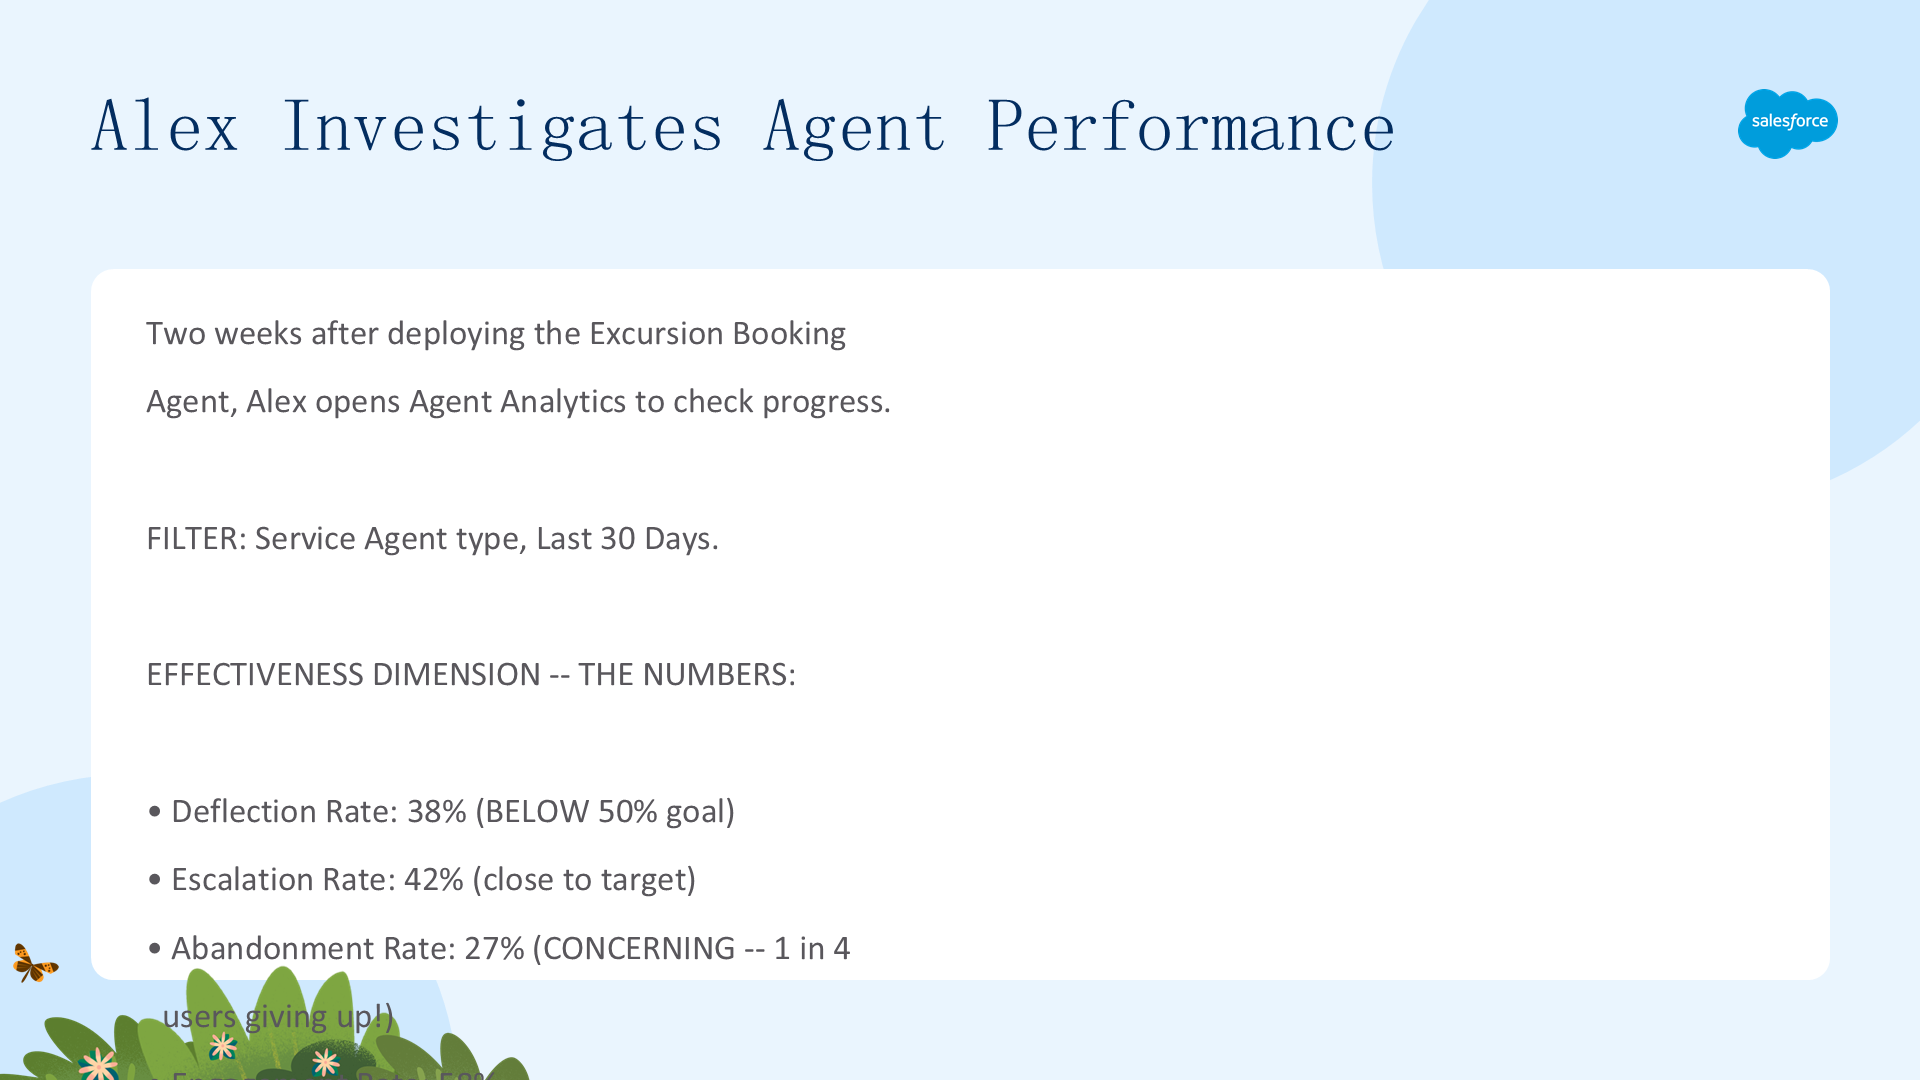
部署 Excursion Booking Agent 两周后,Alex Wu 打开 Agent Analytics 检查进展,看是否达成了「转移 50% 咨询、将升级率降至 50%」的目标。他想要建立对该 Agent 生产环境表现的基本认知。
- Alex 登录 Agentforce Studio。
- 导航到 Observe & Optimize | Analytics。
- 选择 Service Agent 类型,并在过滤栏中将时间范围改为「过去 30 天」。
在 Agent Performance 标签页,他首先查看 Effectiveness 维度标签页:
- 转移率:38%(低于 50% 的目标)
- 升级率:42%(接近目标但仍需改进)
- 放弃率:27%(令人担忧——意味着超过 1/4 的用户在放弃)
- 互动率:58%
- 成功率:71%
Alex 研究聚合有效性指标趋势图,该图展示了 30 天内的全部指标。他注意到放弃率(橙色线)在过去两周持续攀升,而转移率(蓝色线)则趋于平稳。底部的会话结果堆叠柱状图显示,放弃的会话(红色段)在周末显著增加,尤其在 3 月 15–16 日和 3 月 22–23 日出现峰值。
接着,Alex 切换到 Performance Insights 标签页,找出是 Agent 的哪些部分导致了放弃。在 Breakdowns 面板中,他选择:
- 细分类型:Subagents
- 指标:转移率(Deflection Rate)
水平条形图展示了每个子 Agent 的表现:
- General FAQ:绿色(转移率约 65%)
- Water Activities Booking:橙色(转移率约 32%)
- Land Tours Booking:绿色(转移率约 58%)
- Pricing Information:黄色(转移率约 45%)
Alex 将指标改为 放弃率(Abandonment Rate),看到:
- Water Activities Booking:红色(放弃率约 38%)
- General FAQ:绿色(放弃率约 8%)
- Land Tours Booking:黄色(放弃率约 15%)
Alex 学到了什么? Water Activities Booking 子 Agent 表现明显不佳:它的转移率是所有子 Agent 中最低的,放弃率最高(38%,而平均为 27%)。该子 Agent 处理水肺潜水和浮潜预订——这是度假村最受欢迎、利润最高的短途旅行。高放弃率意味着潜在收入正在流失。
据此,Alex 列出了待办事项:
- 调查 Water Activities Booking 子 Agent 的指令,识别可能带来更好结果的改进点。
- 查看该子 Agent 的质量评分,理解响应相关性——Agent 对用户意图的理解程度如何?返回相关结果的效果如何?
- 检查健康度指标(延迟),判断响应缓慢是否是导致放弃的原因之一。
- 与短途旅行前台经理开会,讨论客人常问但 Excursion Booking Agent 可能未回答的问题。
Alex 发现并修复了 Water Activities Booking 子 Agent 中一条含糊的指令,然后在 Agentforce Testing Center 中测试了新版本,部署后继续监控接下来几周的表现。他的努力得到了回报——转移率提高、放弃率降低,与他的业务目标一致。
三、调查 Agent 会话与意图
Sessions & Intents 深入分析
在 Sessions & Intents 中,你可以深入到独立会话以及意图级别的 Agent-用户交互。
- 从 App Launcher 找到并选择 Agentforce Studio。
- 选择 Agents。
- 在 Explorer 的 Observe & Optimize 下,选择 Sessions & Intents。
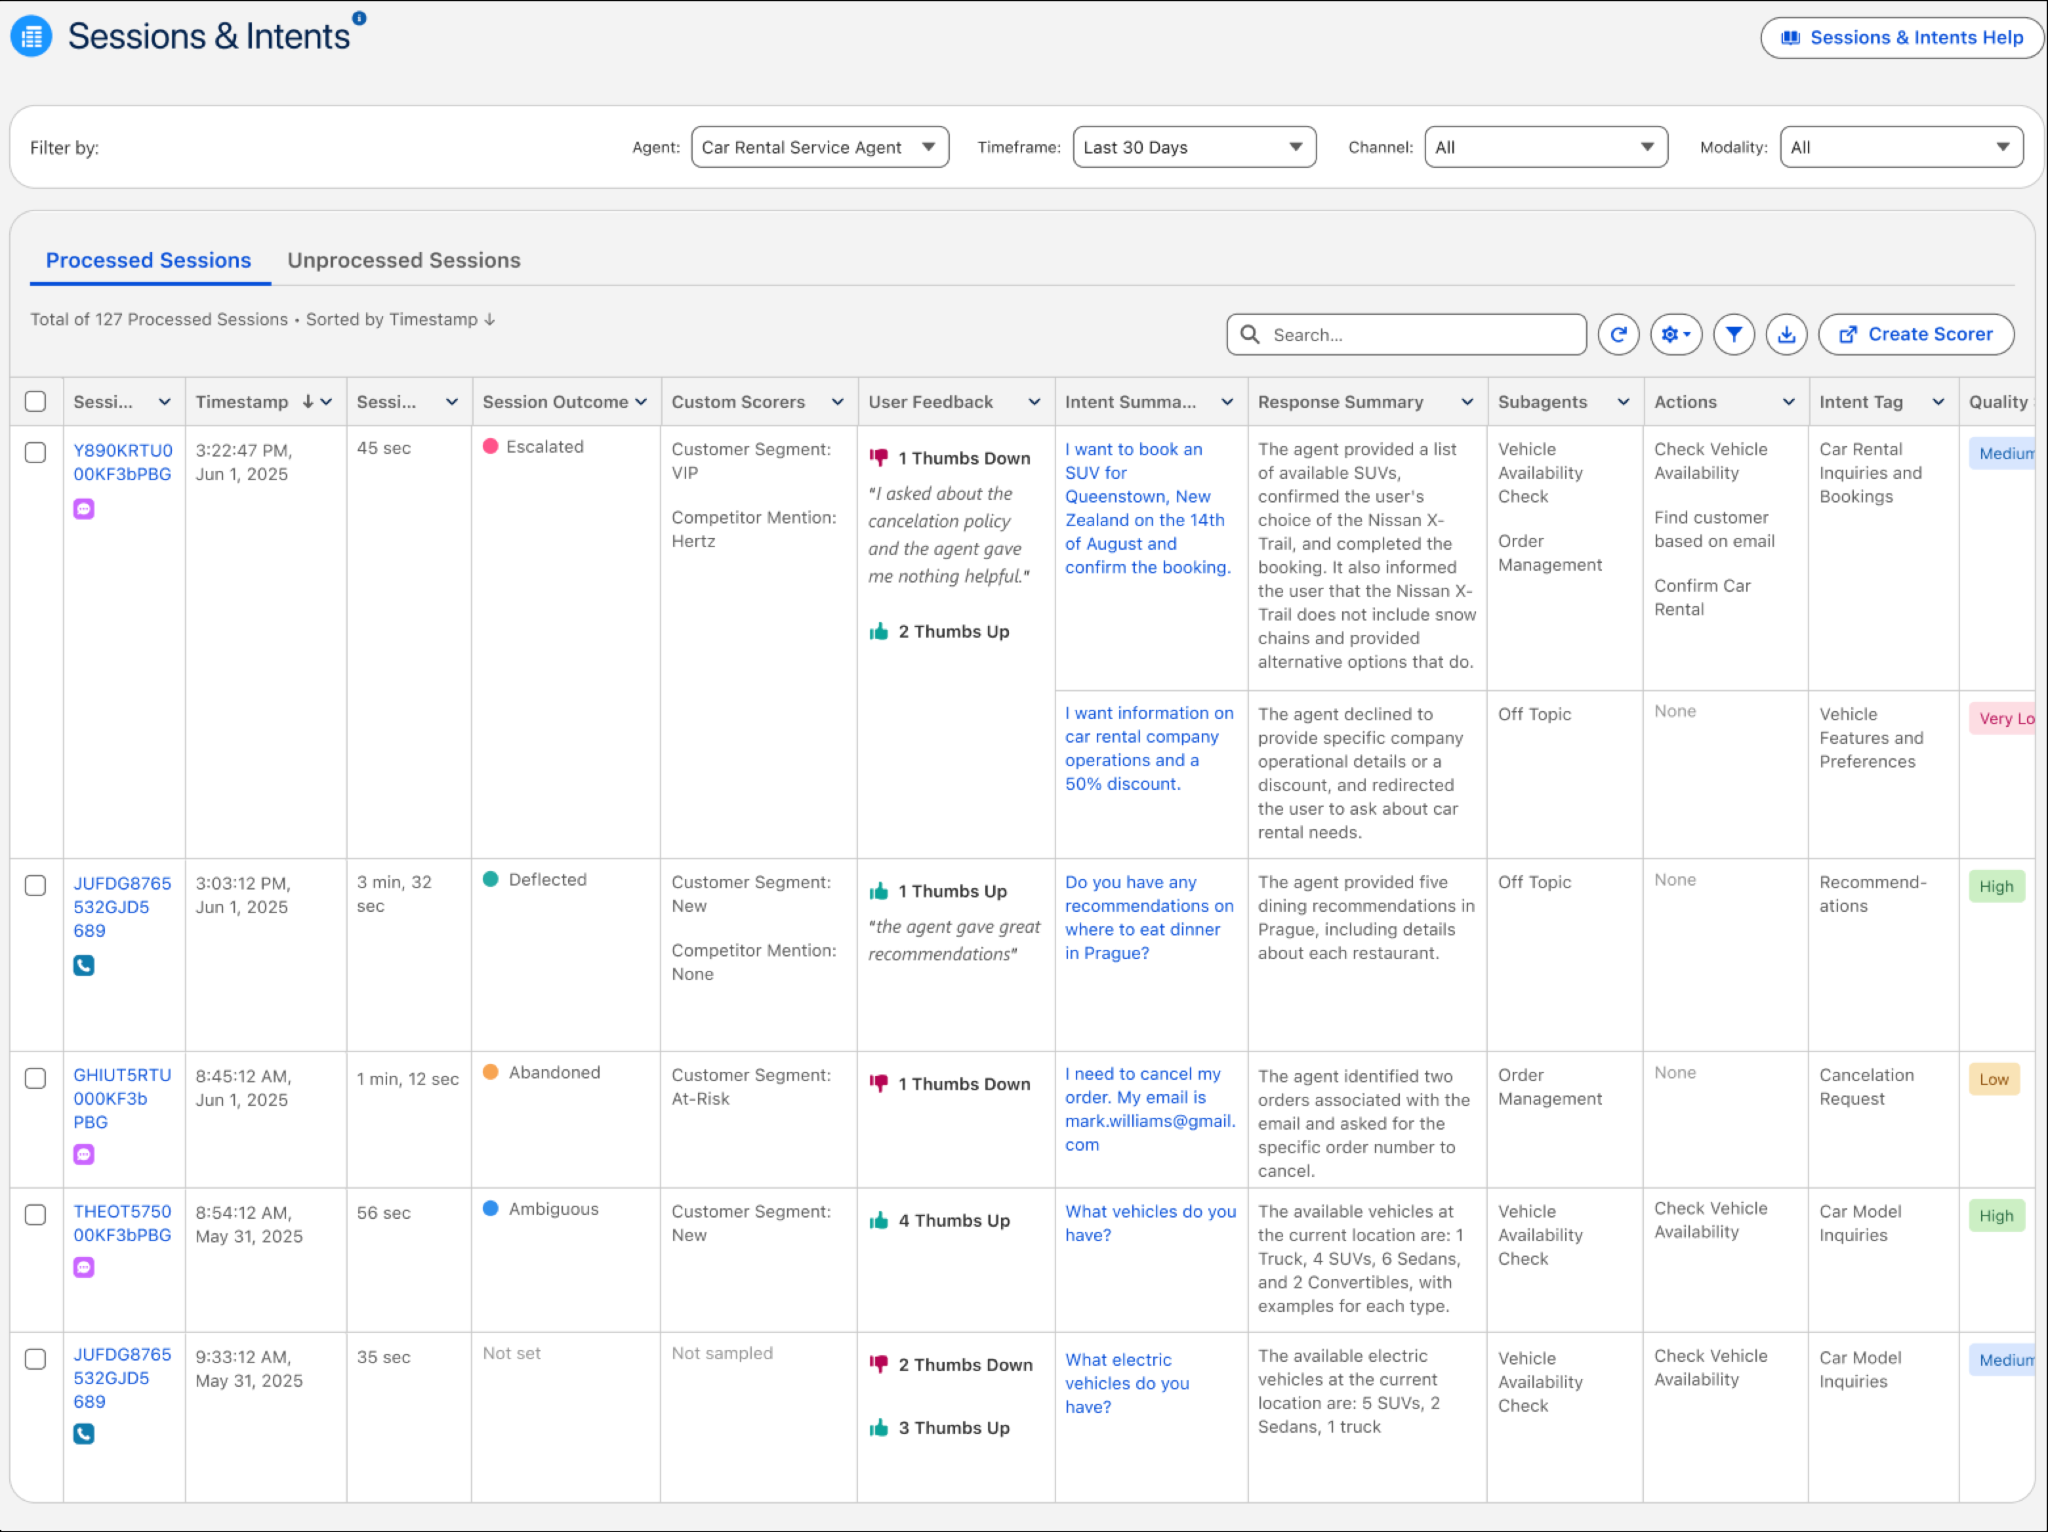
与 Agent Analytics 一样,你可以使用过滤栏来限定页面上显示的数据。

Sessions & Intents 页面有两个标签页:Processed Sessions(已处理会话)和 Unprocessed Sessions(未处理会话)。
已处理会话是系统通过两个顺序管道完全处理过的会话:
- 意图管道(Intent Pipeline):分析已关闭的会话并提取意图——即用户在一组轮次中试图完成的事情。意图生成通常需要 4–5 小时(会话关闭后)。
- 聚类管道(Clustering Pipeline):跨会话对相似意图进行分组,分配聚类标签,并使已打标签的意图在会话跟踪中可见。聚类每周运行一次;一个新主题领域的意图标签要等到每周的聚类运行后才会出现。
已处理会话可直接用于分析:系统已提取用户意图、分配聚类标签并计算质量评分。点击跟踪中的任意意图,即可打开其交互摘要,查看性能指标、触发的子 Agent 和操作,以及质量评分理由(Quality Score Reasoning)。
注意:部分意图不会被标记。聚类管道只有在找到至少 10 个语义相似的意图时才会创建聚类标签。
未处理会话是仍在进行中、刚关闭或尚未完全处理的会话。当会话处理进行中时,会显示蓝色横幅。你可以使用 Trace 标签页立即调查会话,而无需等待处理完成。如果你在已处理会话中找不到某个会话,请检查未处理会话——它可能仍在处理中。
会话表展示关于 Agent-用户会话的信息,每一行代表一个独立会话,包含以下列:
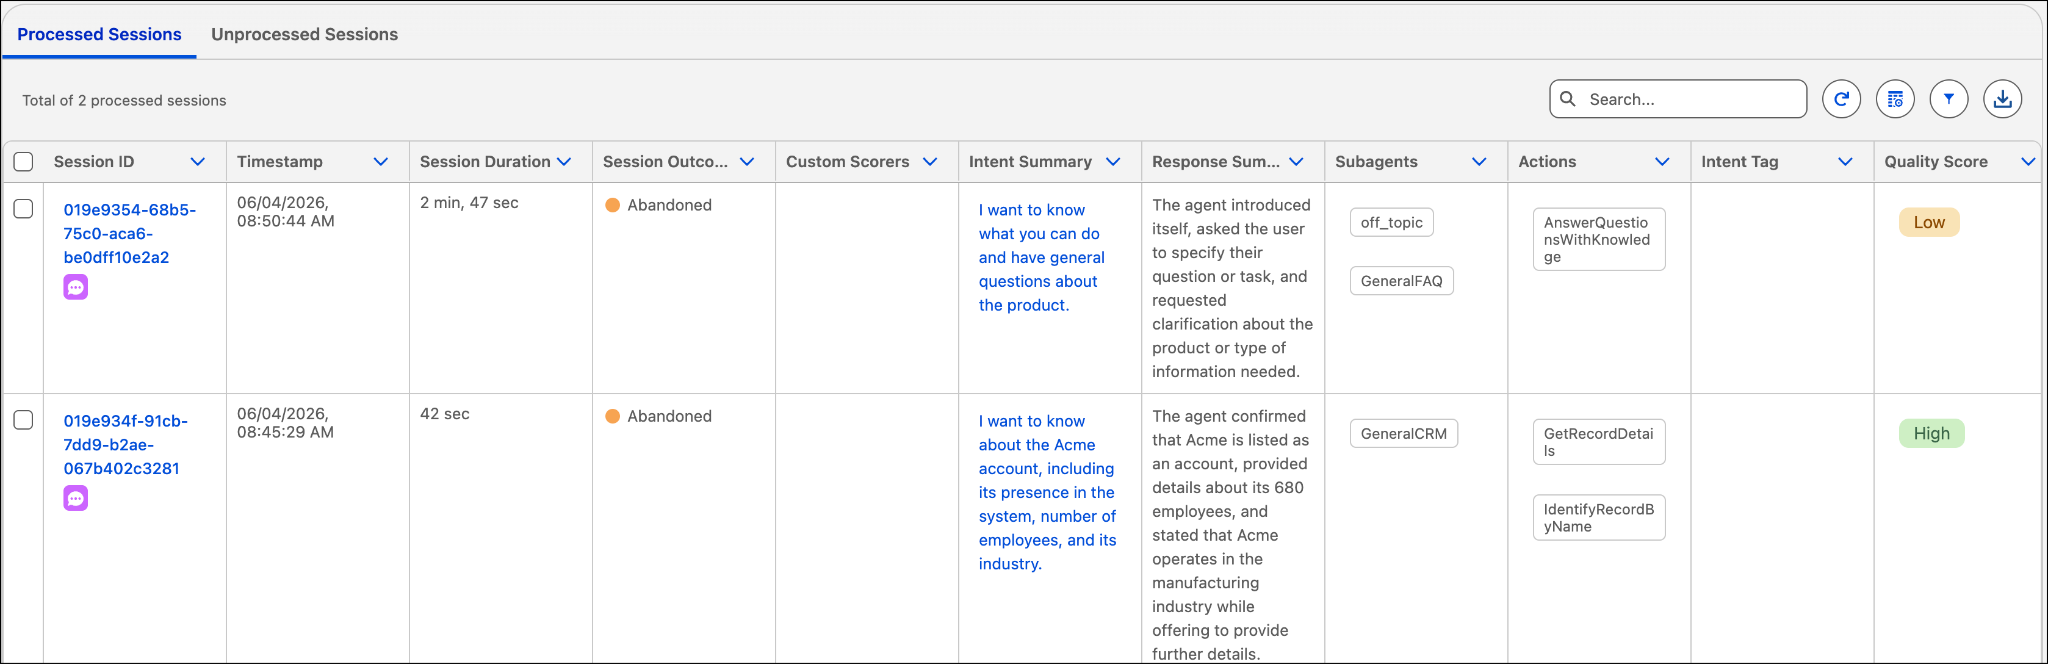
- 会话 ID / 时间戳:唯一标识符和会话开始时间。
- 会话时长:会话总时长。
- 会话结果:会话的结果。
- 自定义评分器(Beta):与会话相关的自定义评分器标签和评分。
- 意图摘要:LLM 生成的关于用户试图完成内容的摘要。
- 响应摘要:Agent 如何响应用户请求的摘要。
- 子 Agent:会话期间调用了哪些子 Agent。
- 操作:Agent 运行的具体操作(例如 Retrieve Knowledge、Get User、Authenticate User)。
- 意图标签:分配给意图的聚类标签(例如 Cancellation Request、Order Status);只有已打标签的意图会显示在此,未打标签的意图为空。
- 质量评分:带颜色编码的评分(High / Medium / Low),附带数值。
点击你想调查的会话 ID,即可打开会话详情页。页面顶部包含会话开始时间戳、唯一会话 ID 和下载转录按钮。
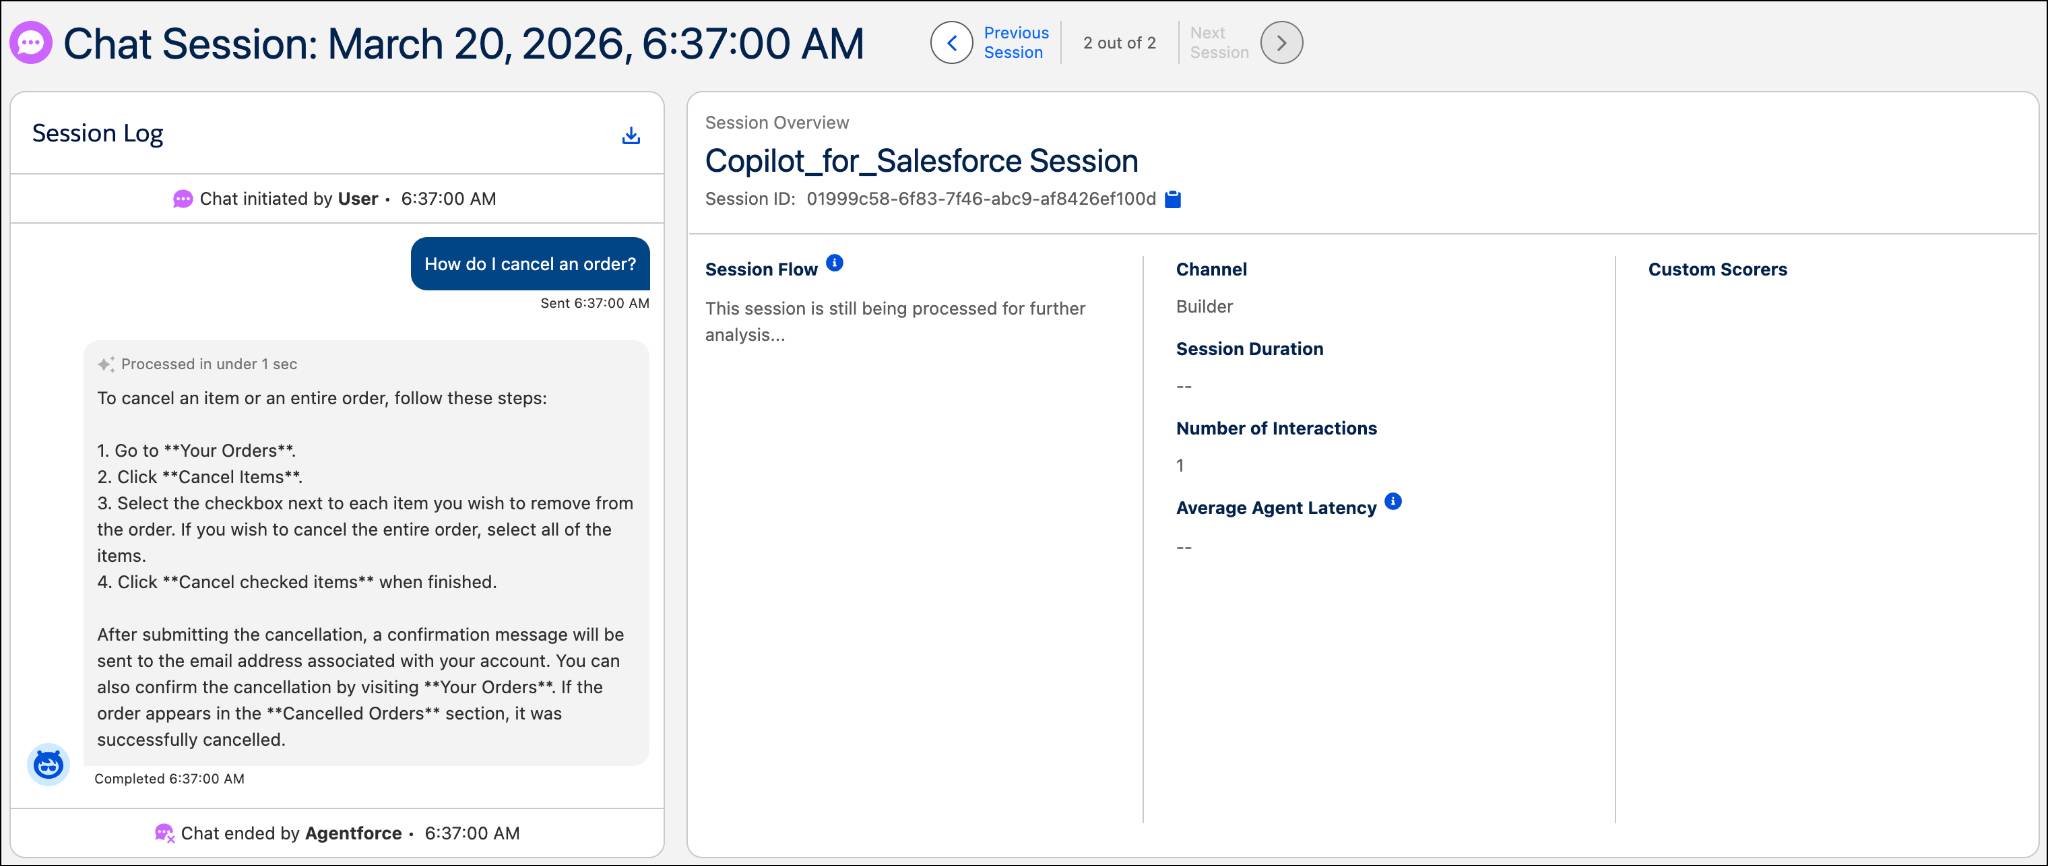
左侧面板显示用户与 Agent 之间的完整对话记录,包含:每条消息的时间戳、颜色编码的气泡(用户消息在右,Agent 消息在左)、处理完成后 Agent 响应上的质量徽章(如 Quality: High 或 Quality: Low 带颜色),以及每条 Agent 响应的完成时间。对于语音会话,左侧面板会显示语音转录以及带播放控件的集成音频播放器。
右侧面板有两个标签页:Interaction Summary(交互摘要)和 Trace(跟踪)。
交互摘要提供所选意图(时刻)中发生情况的结构化拆解:
- Agent 名称:处理此交互的 Agent。
- 平均 Agent 延迟:此意图的平均响应时间(毫秒)。
- 总互动数:此意图中的轮次数量。
- 意图时长:此意图持续了多久。
- 触发的主题:调用的子 Agent(彩色图标)。
- 意图标签:此意图的聚类标签。
- 触发的操作:执行的具体操作。
- 质量评分:带颜色编码的评分徽章(High/Medium/Low)。
- 质量评分理由:LLM 对为何给出该评分的解释,例如「Agent 没有为用户提供关于取消政策的详细响应。」这是最可操作、最能告诉你具体该修复什么的字段。
Trace 标签页显示 Agent 处理的每个步骤按时间排序的记录,并附有每步的耗时。你可以用它:
- 跟踪从用户输入到最终响应的确切步骤序列。
- 查看时间花在了哪里(意图识别、子 Agent 路由、检索、变量更新、操作执行)。
- 识别行为与你在此处配置的内容之间的偏差。
- 展开嵌套的跟踪步骤,下钻到子 Agent 委派。
跟踪中可见的步骤包括:主题(子 Agent)识别、操作(标注操作类型和图标)、Agent 路由步骤、变量更新、检索步骤和响应生成。每一步都显示状态指示器(绿色对勾=成功)和耗时。
Alex 修复 Cancellation & Rescheduling
在 Coral Cloud Resorts,Alex 从客户服务部门收到反馈:访客对 Agent 的取消政策回答感到困惑。
Agent Analytics 揭示了什么:
- Cancellation & Rescheduling 子 Agent 的质量评分为 2.8/5(所有子 Agent 中最低)。
- 升级率为 67%(最高——其他子 Agent 为 28–42%)。
- 答案忠实度(Answer Faithfulness)为 0.54,暗示 Agent 提供的信息与知识库实际内容不一致。
Alex 深入 Sessions & Intents,按以下条件过滤:子 Agent 为 Cancellation & Rescheduling、会话结果为 Escalated、质量评分 Low(1.0–3.0),然后打开前 10 个已升级的会话。
会话 #1——质量评分 2.2:
- 用户:「如果有飓风警报,我可以取消我的短途旅行吗?」
- Agent:「我们的取消政策允许在计划行程前 48 小时内免费取消。之后将收取 50% 的费用。」
- 用户:「但天气紧急情况呢?」
- Agent:「您可以提前 24 小时重新安排行程,费用为 25 美元。」
- 用户:「这没有回答我关于飓风的问题。」
- Agent:「让我帮您联系我们的客服团队,他们可以针对您的具体情况提供帮助。」
交互摘要显示答案忠实度 0.42,质量评分理由为:「Agent 提供了通用的政策信息,没有解决天气紧急情况例外。关于 48 小时和 24 小时窗口的回答似乎不一致。」Trace 标签页显示:检索知识 → 检索到「短途旅行取消政策」文章 → Agent 生成关于 48 小时政策的回复 → 检索知识 → 检索到「改期指南」文章 → Agent 生成关于 24 小时改期的回复 → Agent 升级到支持代表。
会话 #2——质量评分 1.9:用户询问因疾病取消;Agent 提供标准 48 小时取消政策;用户询问是否有医疗原因的例外;Agent 重复同样的政策;用户请求支持代表。Trace 显示 Agent 只检索了基础的「短途旅行取消政策」文章,从未搜索医疗例外信息。
会话 #3——质量评分 2.5:用户购买了旅行保险,想知道它如何影响取消;Agent 描述了标准取消费用;用户对未考虑保险感到沮丧;最终升级。
调查知识库:Alex 点击阅读 Trace 中引用的知识文章,发现有两篇独立的文章,但都未能充分涵盖:飓风警报但度假村尚未正式取消时怎么办、医疗紧急取消、旅行保险如何影响取消(仅在改期中提及)。知识库存在碎片化和信息不完整的问题:
- 多篇重叠文章造成混淆(取消政策与改期政策分离)。
- 缺少例外场景(客人生病、家庭紧急情况、旅行保险对取消的覆盖)。
- 天气政策含糊(只覆盖度假村发起的取消,不覆盖客人因天气担忧而发起的取消)。
Agent 的答案忠实度评分低(0.54),是因为它从多篇不完整的文章中综合生成响应,产生了不一致的回答。
实施修复:Alex 与法务和客户服务团队合作,创建了一篇单一、全面的文章 Complete Excursion Cancellation & Rescheduling Policy,解决知识库中的问题。Alex 归档了旧的碎片化文章,确保 Agent 只检索新的全面文章,避免信息冲突。
他还更新了 Cancellation & Rescheduling 子 Agent 的指令,让其询问用户的旅行保险情况、取消原因,并将回答基于完整的政策文档。他在 Agentforce Testing Center 中测试了新版本,并部署到生产环境。三周后,Alex 检查指标:
- 质量评分:4.3/5(从 2.8 提升)
- 答案忠实度:0.91(从 0.54 提升)
- 升级率:28%(从 67% 下降)
- 会话量:过去 30 天 423 次 → 447 次(随着用户更信任 Agent,量有所增加)
Alex 抽样了 15 个近期的取消会话,发现 Trace 一致地检索了那篇单一全面文章,天气相关问题得到了正确且具体的政策解答,医疗和保险问题也得到了妥善处理。质量评分理由为:「Agent 提供了准确、完整的信息,直接回应用户的具体取消场景。」
整合后的知识库消除了矛盾并填补了覆盖空白,显著提升了转移率和质量。
总结
你学习了如何使用 Agentforce Monitoring 工具——包括 Agent Analytics 仪表板和 Sessions & Intents——从有效性、质量、健康度等多个维度观察、衡量和理解 Agent 的真实表现。你探索了如何过滤数据、解读指标、调查独立会话,并逐步跟踪 Agent 行为以识别表现不佳的领域。
监控的核心是一个可重复的工作流:
- 在构思阶段设定目标(ADLC)——可衡量的、以结果为导向的 KPI。
- 用 Agent Analytics 监控——广泛视图(有效性、使用情况、质量、健康度、信任、语音)+ Performance Insights 按子 Agent/意图/操作细分,识别表现不佳的领域。
- 用 Sessions & Intents 调查——审查独立对话、交互摘要 + 质量评分理由、Trace 标签页逐步调试。
- 诊断根本原因——是 Agent 配置问题、知识库问题,还是缺少场景?用 Trace 看清楚到底发生了什么。
- 修复并验证——更新知识文章、优化指令、修复配置,在 Agentforce Testing Center 中测试,部署并监控改进。
Alex 在 Coral Cloud Resorts 的成果印证了这一工作流:通过 Performance Insights 识别出 Water Activities Booking 表现不佳,通过知识库整合将 Cancellation & Rescheduling 的质量评分从 2.8 提升到 4.3。ADLC 是一个循环——监控 → 学习 → 改进 → 部署 → 监控。每一轮循环都会产出一个更好的 Agent,带来更好的结果。现在你可以应用这些监控技能来发现趋势、揭示根本原因,并持续改进你的 Agent。